







Die lineare Regression ist möglicherweise der grundlegendste und zugänglichste Algorithmus des maschinellen Lernens (ML), zugleich aber auch einer der schnellsten und leistungsfähigsten. Daher verlassen sich Fachleute aus Wirtschaft, Wissenschaft und akademischer Forschung häufig auf diese weit verbreitete Methode für prädiktive Analysen. Wenn Sie verstehen, wie lineare Regression funktioniert, welche Typen und Eigenschaften sie hat, welche wesentlichen Vorteile sie bietet und in welchen Bereichen sie hauptsächlich eingesetzt wird, können Sie sie in Ihrem Unternehmen optimal nutzen.
- DIE WICHTIGSTEN ERKENNTNISSE
- Was ist lineare Regression und wie funktioniert sie?
- Funktionsweise der linearen Regression
- Unabhängige und abhängige Variablen bei der linearen Regression
- Vier Arten der linearen Regression
- Wichtige Annahmen und Einschränkungen der linearen Regression
- Anwendungen der linearen Regression in verschiedenen Bereichen
- Software für lineare Regression
- Häufige Herausforderungen und Lösungen bei der linearen Regression
- Fazit: Die Möglichkeiten der linearen Regression ausschöpfen
DIE WICHTIGSTEN ERKENNTNISSE
- •Zu den drei Arten der linearen Regression gehören die einfache (einfache Variable), die multiple und die polynomiale Regression. (Zum Abschnitt springen)
- •Lineare Regression wird in verschiedenen Bereichen eingesetzt – von Wirtschaft und Ökonomie bis hin zum Gesundheitswesen und den Sozialwissenschaften. (Zum Abschnitt springen)
- •Für die gängigen Herausforderungen beim Einsatz linearer Regressionsmodelle stehen wirksame Methoden zur Verfügung. (Zum Abschnitt springen)
Was ist lineare Regression und wie funktioniert sie?
Auf der grundlegendsten Ebene nutzt die lineare Regression eine Variable – die unabhängige Variable –, um den Wert einer anderen Variable vorherzusagen: der abhängigen Variable. Diese unkomplizierte Formel für präzise Vorhersagen ermöglicht hochgradig erklärbare künstliche Intelligenz (XAI), die schnell trainiert werden kann.
Ihren Ursprung hat sie in der Entwicklung statistischer Methoden zur Analyse menschlicher Körpermaße, die der Naturforscher und Verhaltensgenetiker Sir Francis Galton im viktorianischen Zeitalter vorantrieb. Bei der Untersuchung der relativen Körpergröße von Vätern und Söhnen stellte Galton fest, dass die Nachkommen im Vergleich zu ihren Eltern tendenziell weniger vom Mittelwert der Körpergröße in der Bevölkerung abwichen – selbst wenn überdurchschnittlich große Väter typischerweise überdurchschnittlich große Söhne hatten.
Dieses statistische Phänomen – die „Regression zum Mittelwert“ – besagt, dass bei einem extremen Stichprobenwert einer Zufallsvariablen nachfolgende Stichproben derselben Zufallsvariablen nahe am Mittelwert der Grundgesamtheit liegen werden.
Funktionsweise der linearen Regression
Die lineare Regression beruht auf der Annahme, dass nach extremen Ergebnissen in zufälligen Datenstichproben wahrscheinlich normalere Datenpunkte folgen – und dass sich zwischen den dargestellten Datenpunkten eine gerade Linie ziehen lässt. Diese Linie kann als Referenz dienen, um Abweichungen zwischen vorhergesagten und tatsächlichen Ausgabewerten zu minimieren. Darüber hinaus lassen sich aus der Regressionsanalyse statistische Methoden ableiten, mit denen sich Beziehungen zwischen abhängigen Variablen und einer oder mehreren unabhängigen Variablen schätzen lassen.
Das Phänomen der Regression zum Mittelwert gilt für praktisch jedes messbare Merkmal von Eltern und Nachkommen. Statistiker erkennen darin eine mathematische Tatsache der natürlichen Variation bei wiederholten Daten und stützen sich auf diese Annahme, um unerwartete Unterschiede zwischen vorhergesagten und tatsächlichen Ausgabewerten zu minimieren.
Unabhängige und abhängige Variablen bei der linearen Regression
In der Regressionsanalyse ist die Ergebnisvariable die abhängige Variable, während die Störvariable als Prädiktor oder unabhängige Variable bezeichnet wird. Einfach ausgedrückt ist die unabhängige Variable X die Ursache und die abhängige Variable Y die Wirkung. So schienen die beobachteten Daten aus Galtons Forschung auf einen Zusammenhang zwischen zwei Variablen hinzudeuten – der Körpergröße eines Vaters und der seines Sohnes. Daher wäre allgemein zu erwarten, dass die Körpergröße eines großen Vaters (X) zu einem großen Sohn (Y) führt.
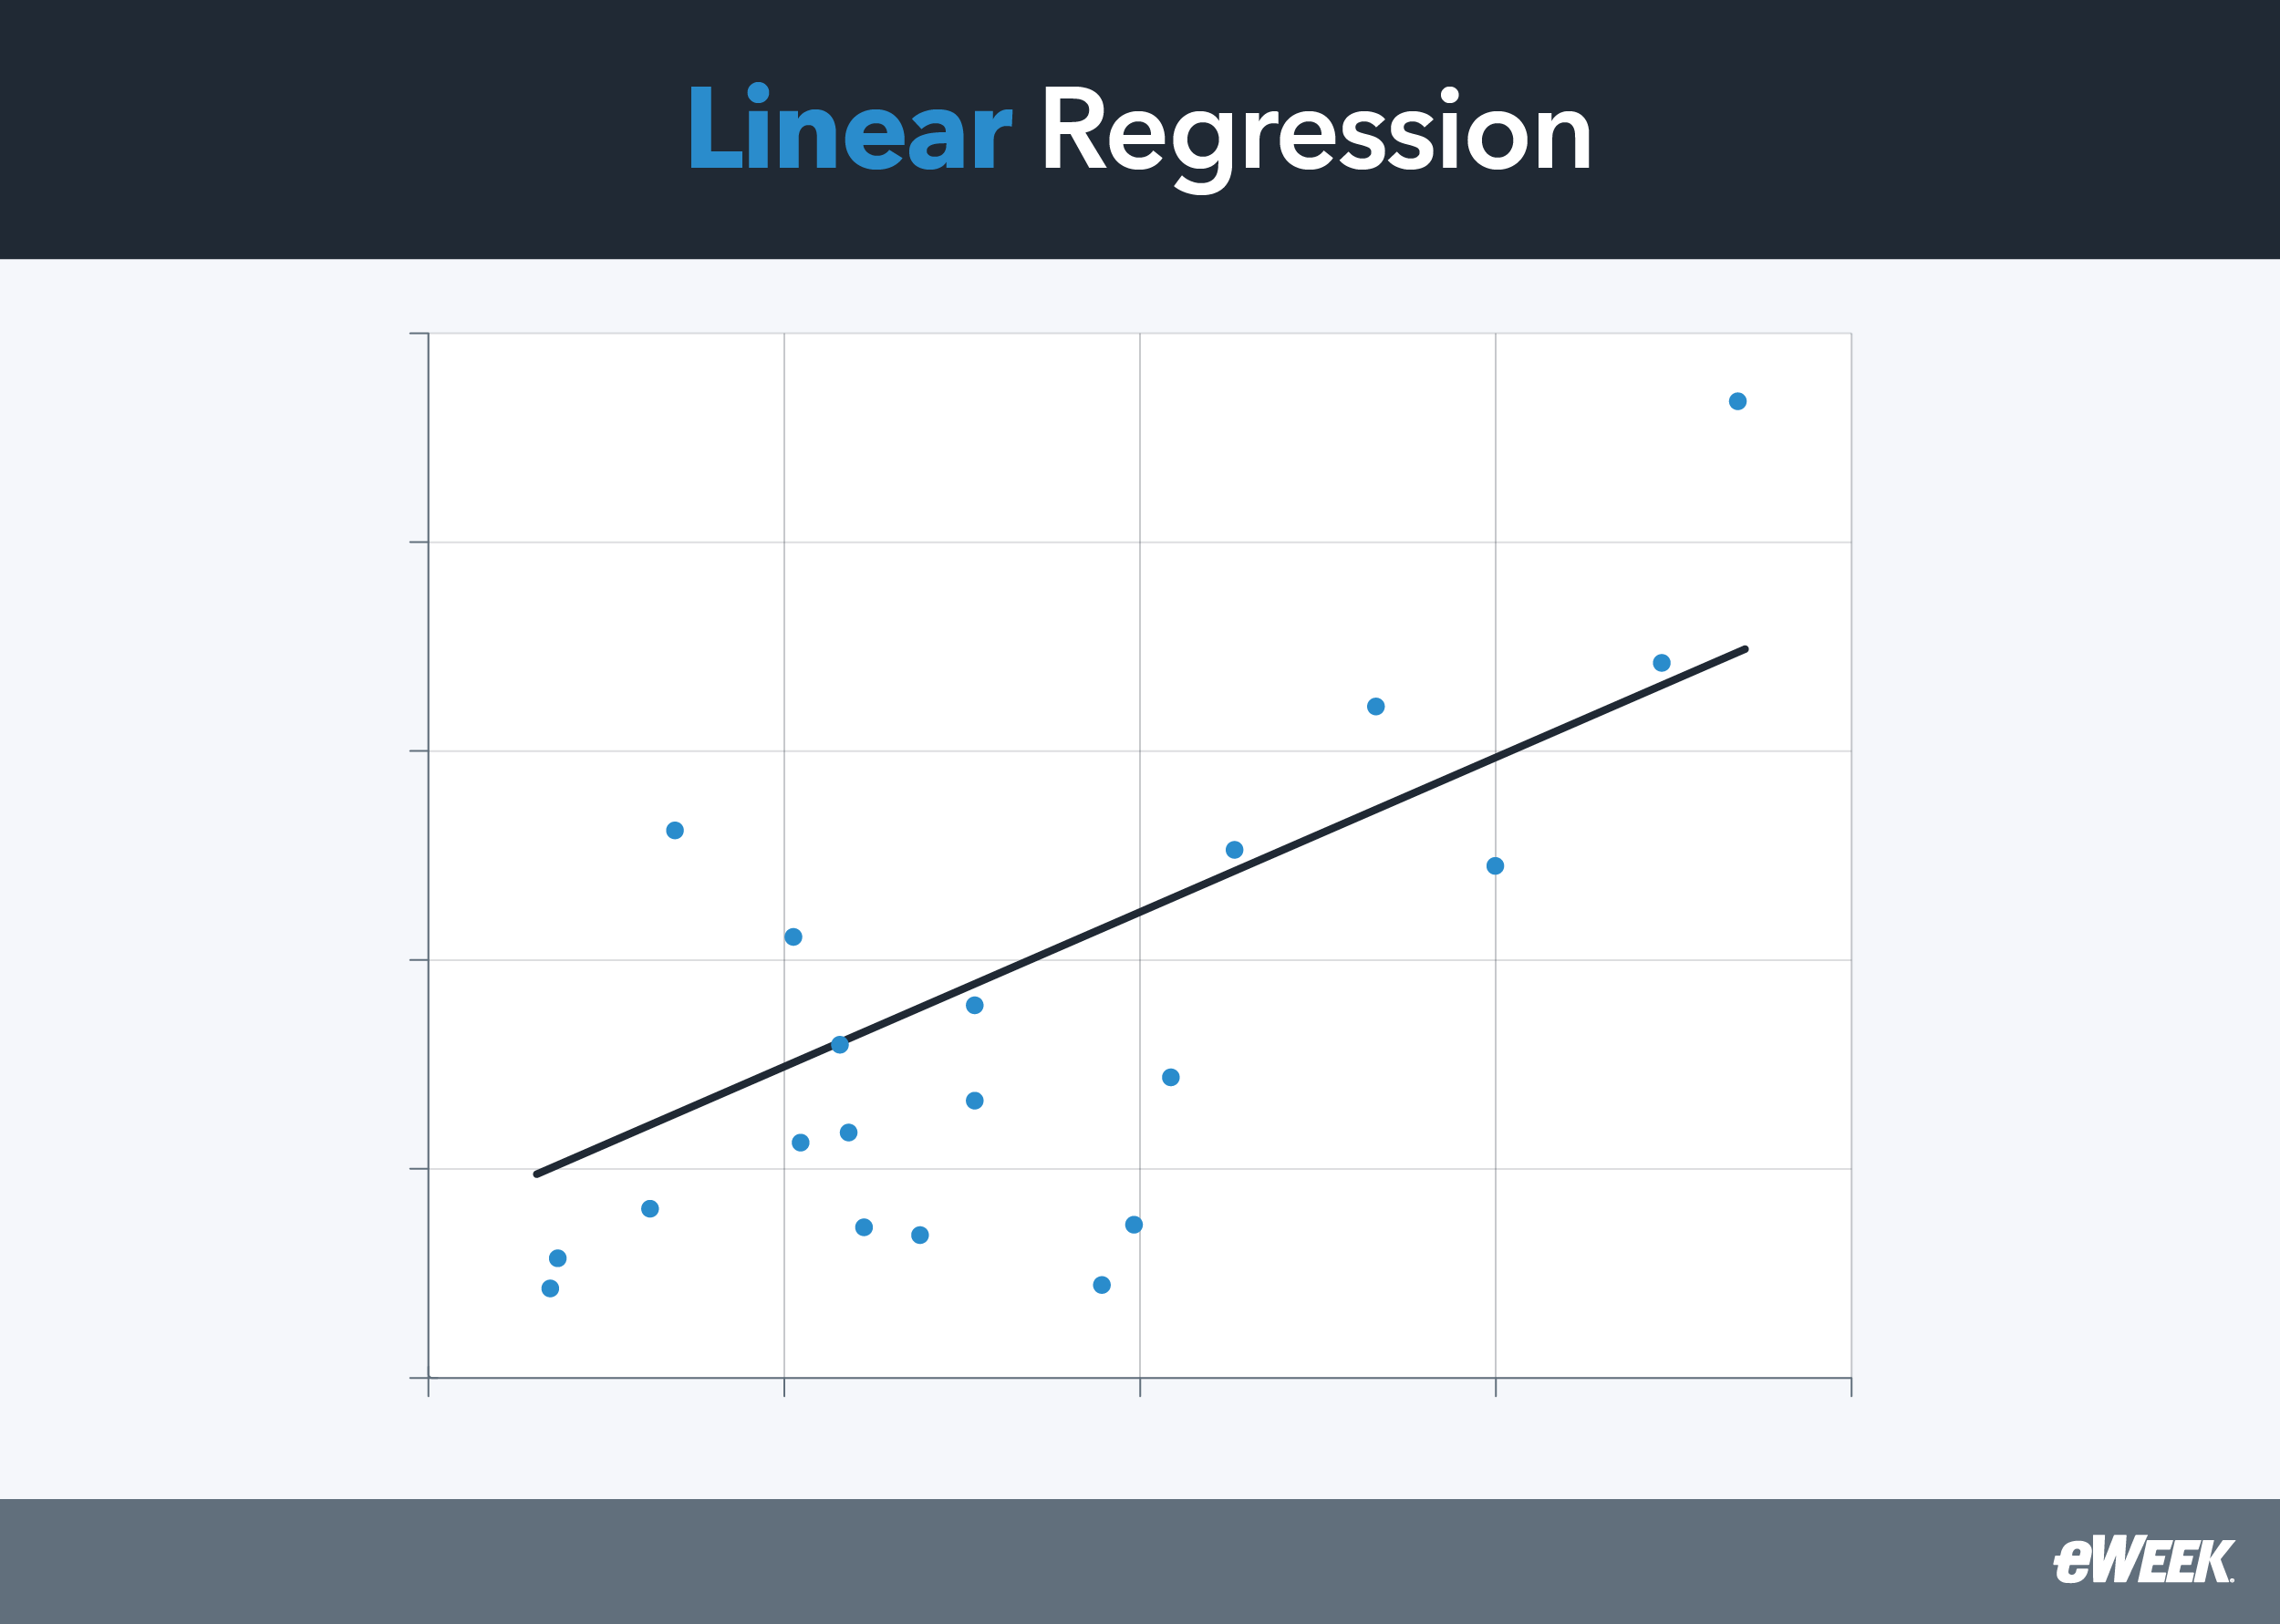
In einem Diagramm der linearen Regression stellt die gerade Linie den bestmöglichen Versuch dar, die Summe der Quadrate der Residuen zwischen bekannten oder beobachteten Datenpunkten und den vorhergesagten Datenpunkten zu minimieren. Deshalb wird die Regressionslinie auch als Ausgleichsgerade bezeichnet, und die für diese Anpassung verwendete Methode heißt Methode der kleinsten Quadrate.
Den Zusammenhang zwischen den Variablen verstehen
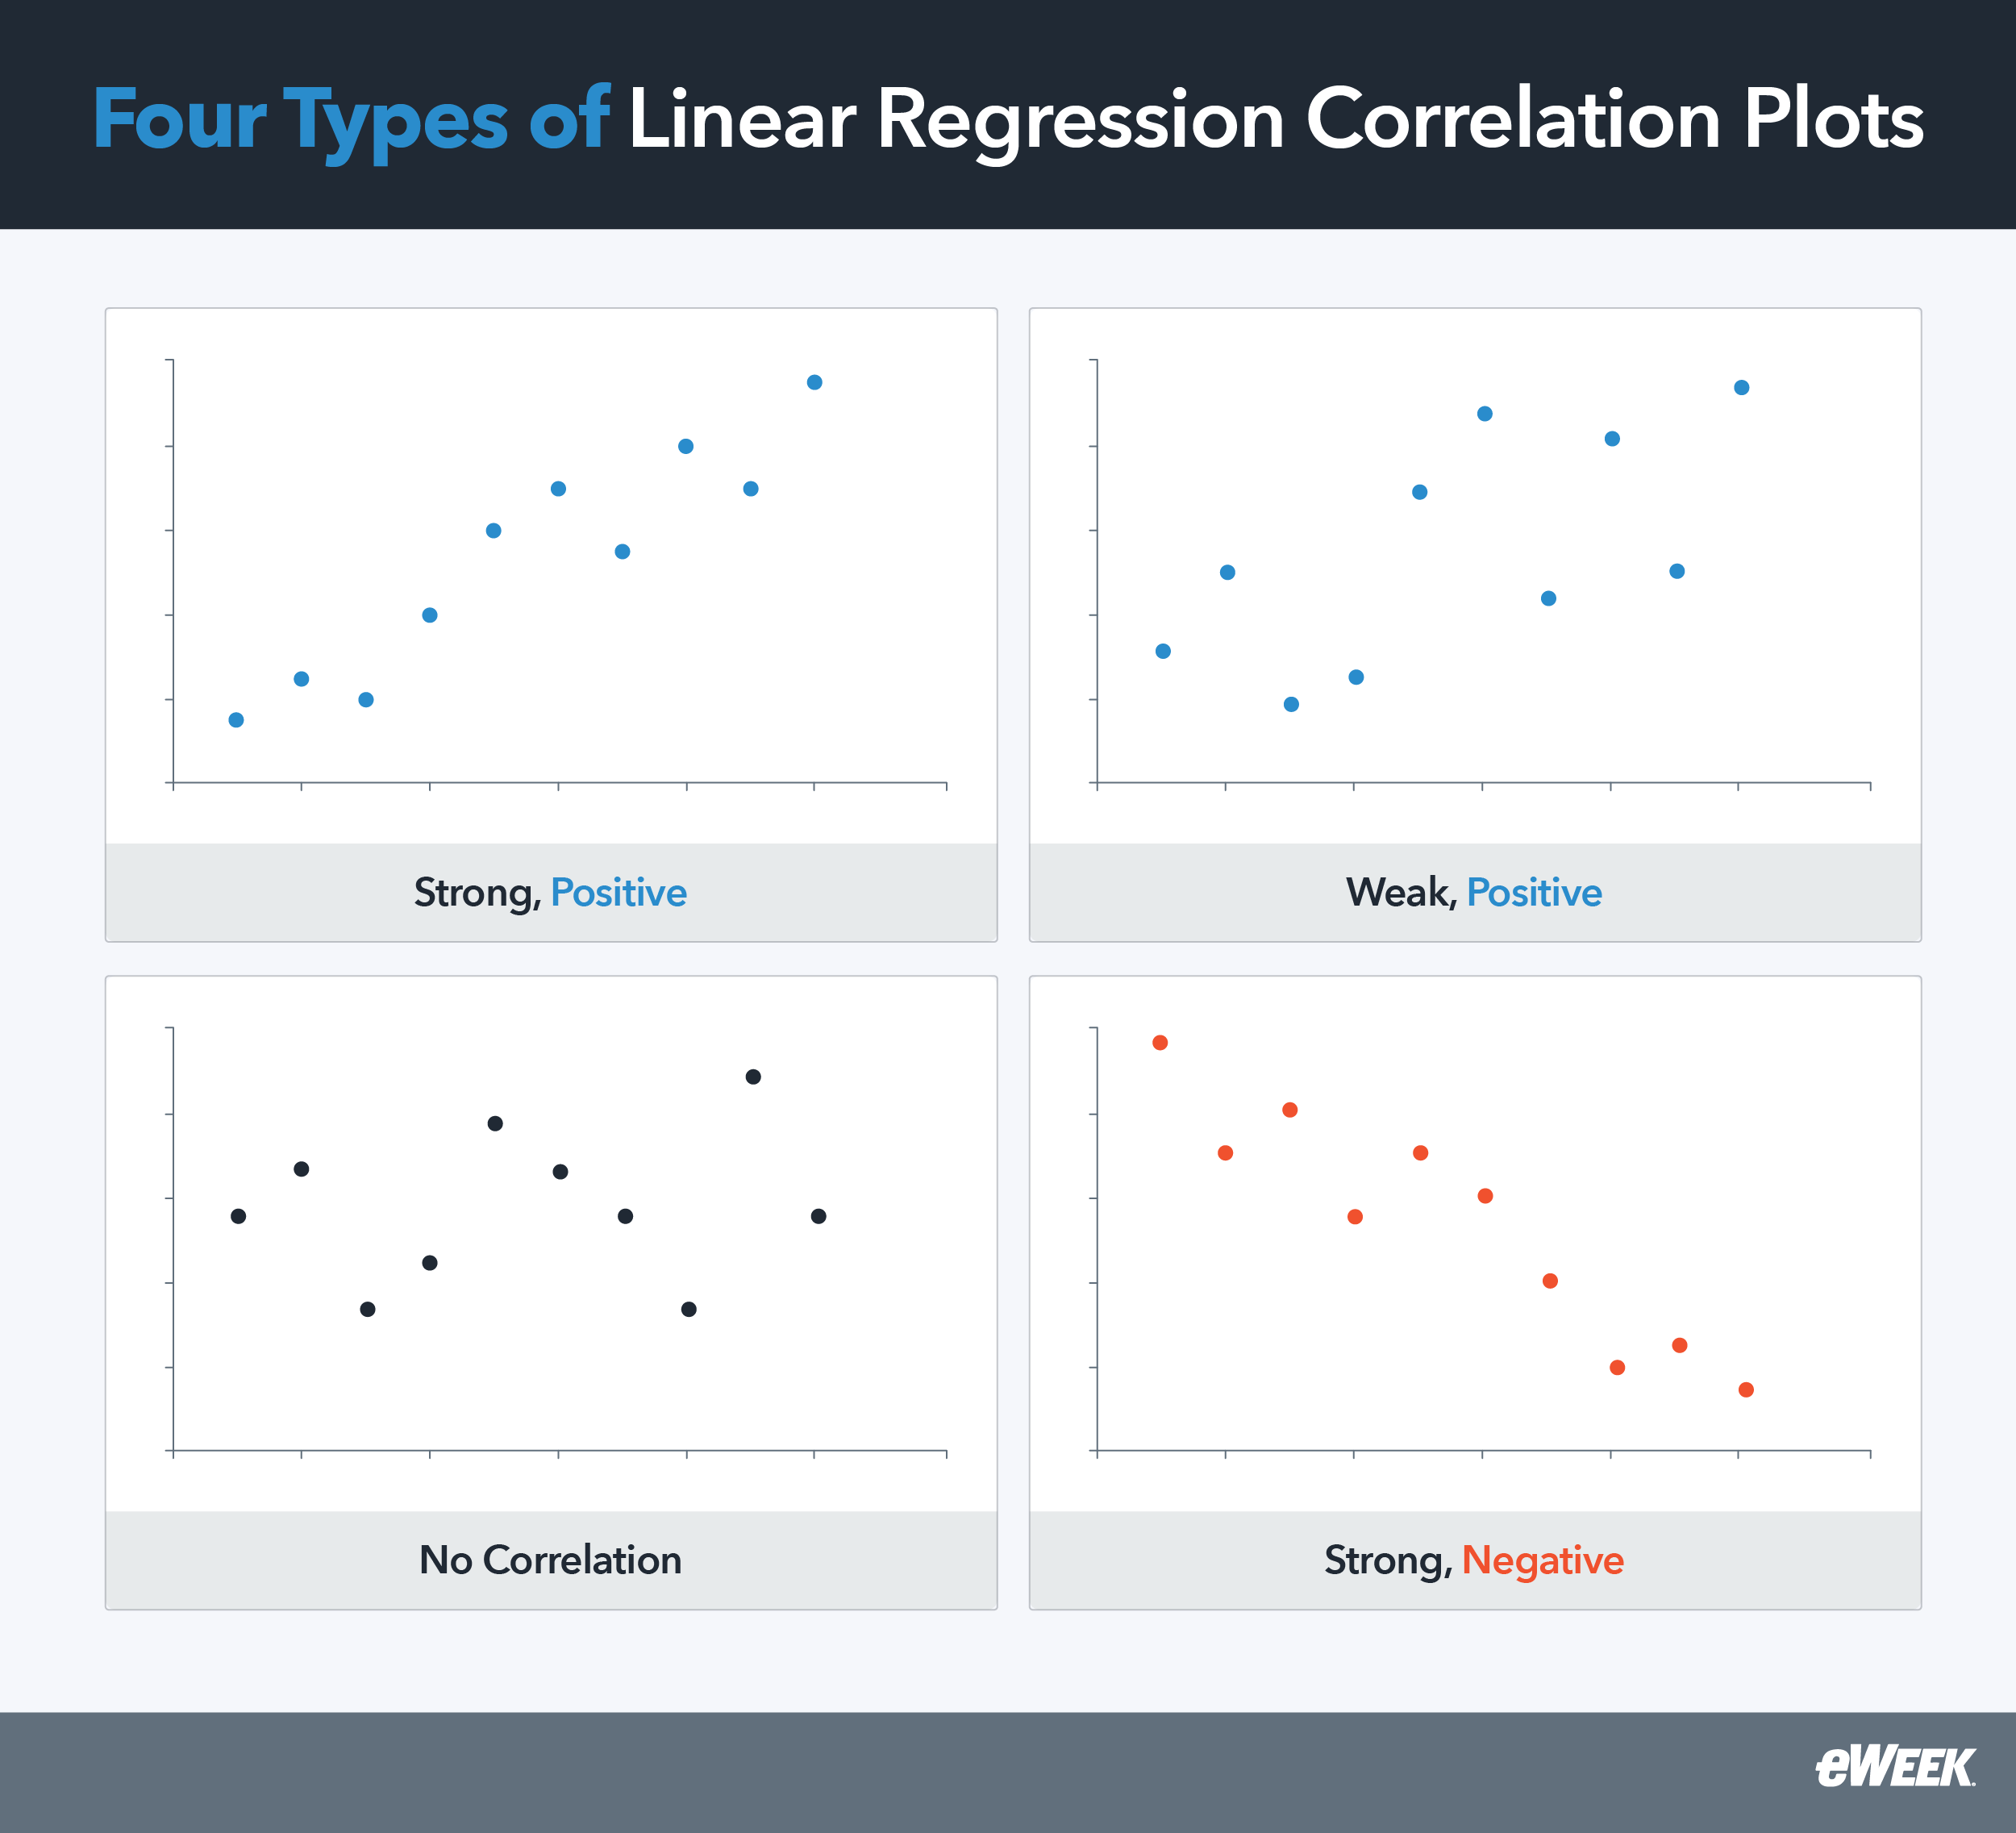
Die Regressionslinie zeigt an, wo die mittleren Datenpunkte voraussichtlich liegen. Durch die Analyse der Richtung der Linie und der Streuung der Datenpunkte um sie herum können Sie Rückschlüsse auf den Zusammenhang zwischen den Variablen ziehen. Die folgende Abbildung zeigt die vier grundlegenden Szenarien, in denen eine kontinuierliche Variable auf der X-Achse und die andere auf der Y-Achse dargestellt wird.
Szenario 1 zeigt eine starke positive Korrelation zwischen den Variablen X und Y, während Szenario 2 eine schwache positive Korrelation darstellt. In beiden Fällen verläuft die Regressionslinie von links nach rechts aufwärts. Galtons Beobachtungen sind ein Beispiel für eine positive Korrelation: Eine Zunahme der Körpergröße des Vaters korreliert mit einer Zunahme der Körpergröße des Sohnes. Szenario 3zeigt, dass keine Korrelation zwischen den Variablen X und Y besteht. In diesem Fall ist die Regressionslinie horizontal. Szenario 4 zeigt eine starke negative Korrelation mit einer von links nach rechts abwärts verlaufenden Regressionslinie. So kann beispielsweise die Zahl der Stunden, die mit Sport verbracht werden, negativ mit dem Gewicht korrelieren, da mehr Bewegung zu Gewichtsverlust führen kann.
Koeffizienten schätzen und Werte vorhersagen
Die Gleichung y = mx +b stellt die grundlegendste Gleichung der linearen Regression dar:
- x ist die Prädiktor- oder unabhängige Variable
- y ist die abhängige Variable oder zu bestimmende Variable
- m ist die geschätzte Steigung der Regressionslinie
- b ist der geschätzte Achsenabschnitt, an dem die Regressionslinie die y-Achse schneidet, wenn x auf 0 gesetzt wird
In dieser grundlegenden Gleichung der linearen Regression würde die Bestimmung von m Ihnen die Änderungsrate zwischen x und y verraten; m ist als zentraler Regressionskoeffizient oder unbekannter Parameter definiert, der die Beziehung zwischen x und y beschreibt. Mit anderen Worten: Wenn Sie den Wert von m kennen, können Sie den Wert von y mithilfe eines bekannten x-Werts vorhersagen.
Vier Arten der linearen Regression
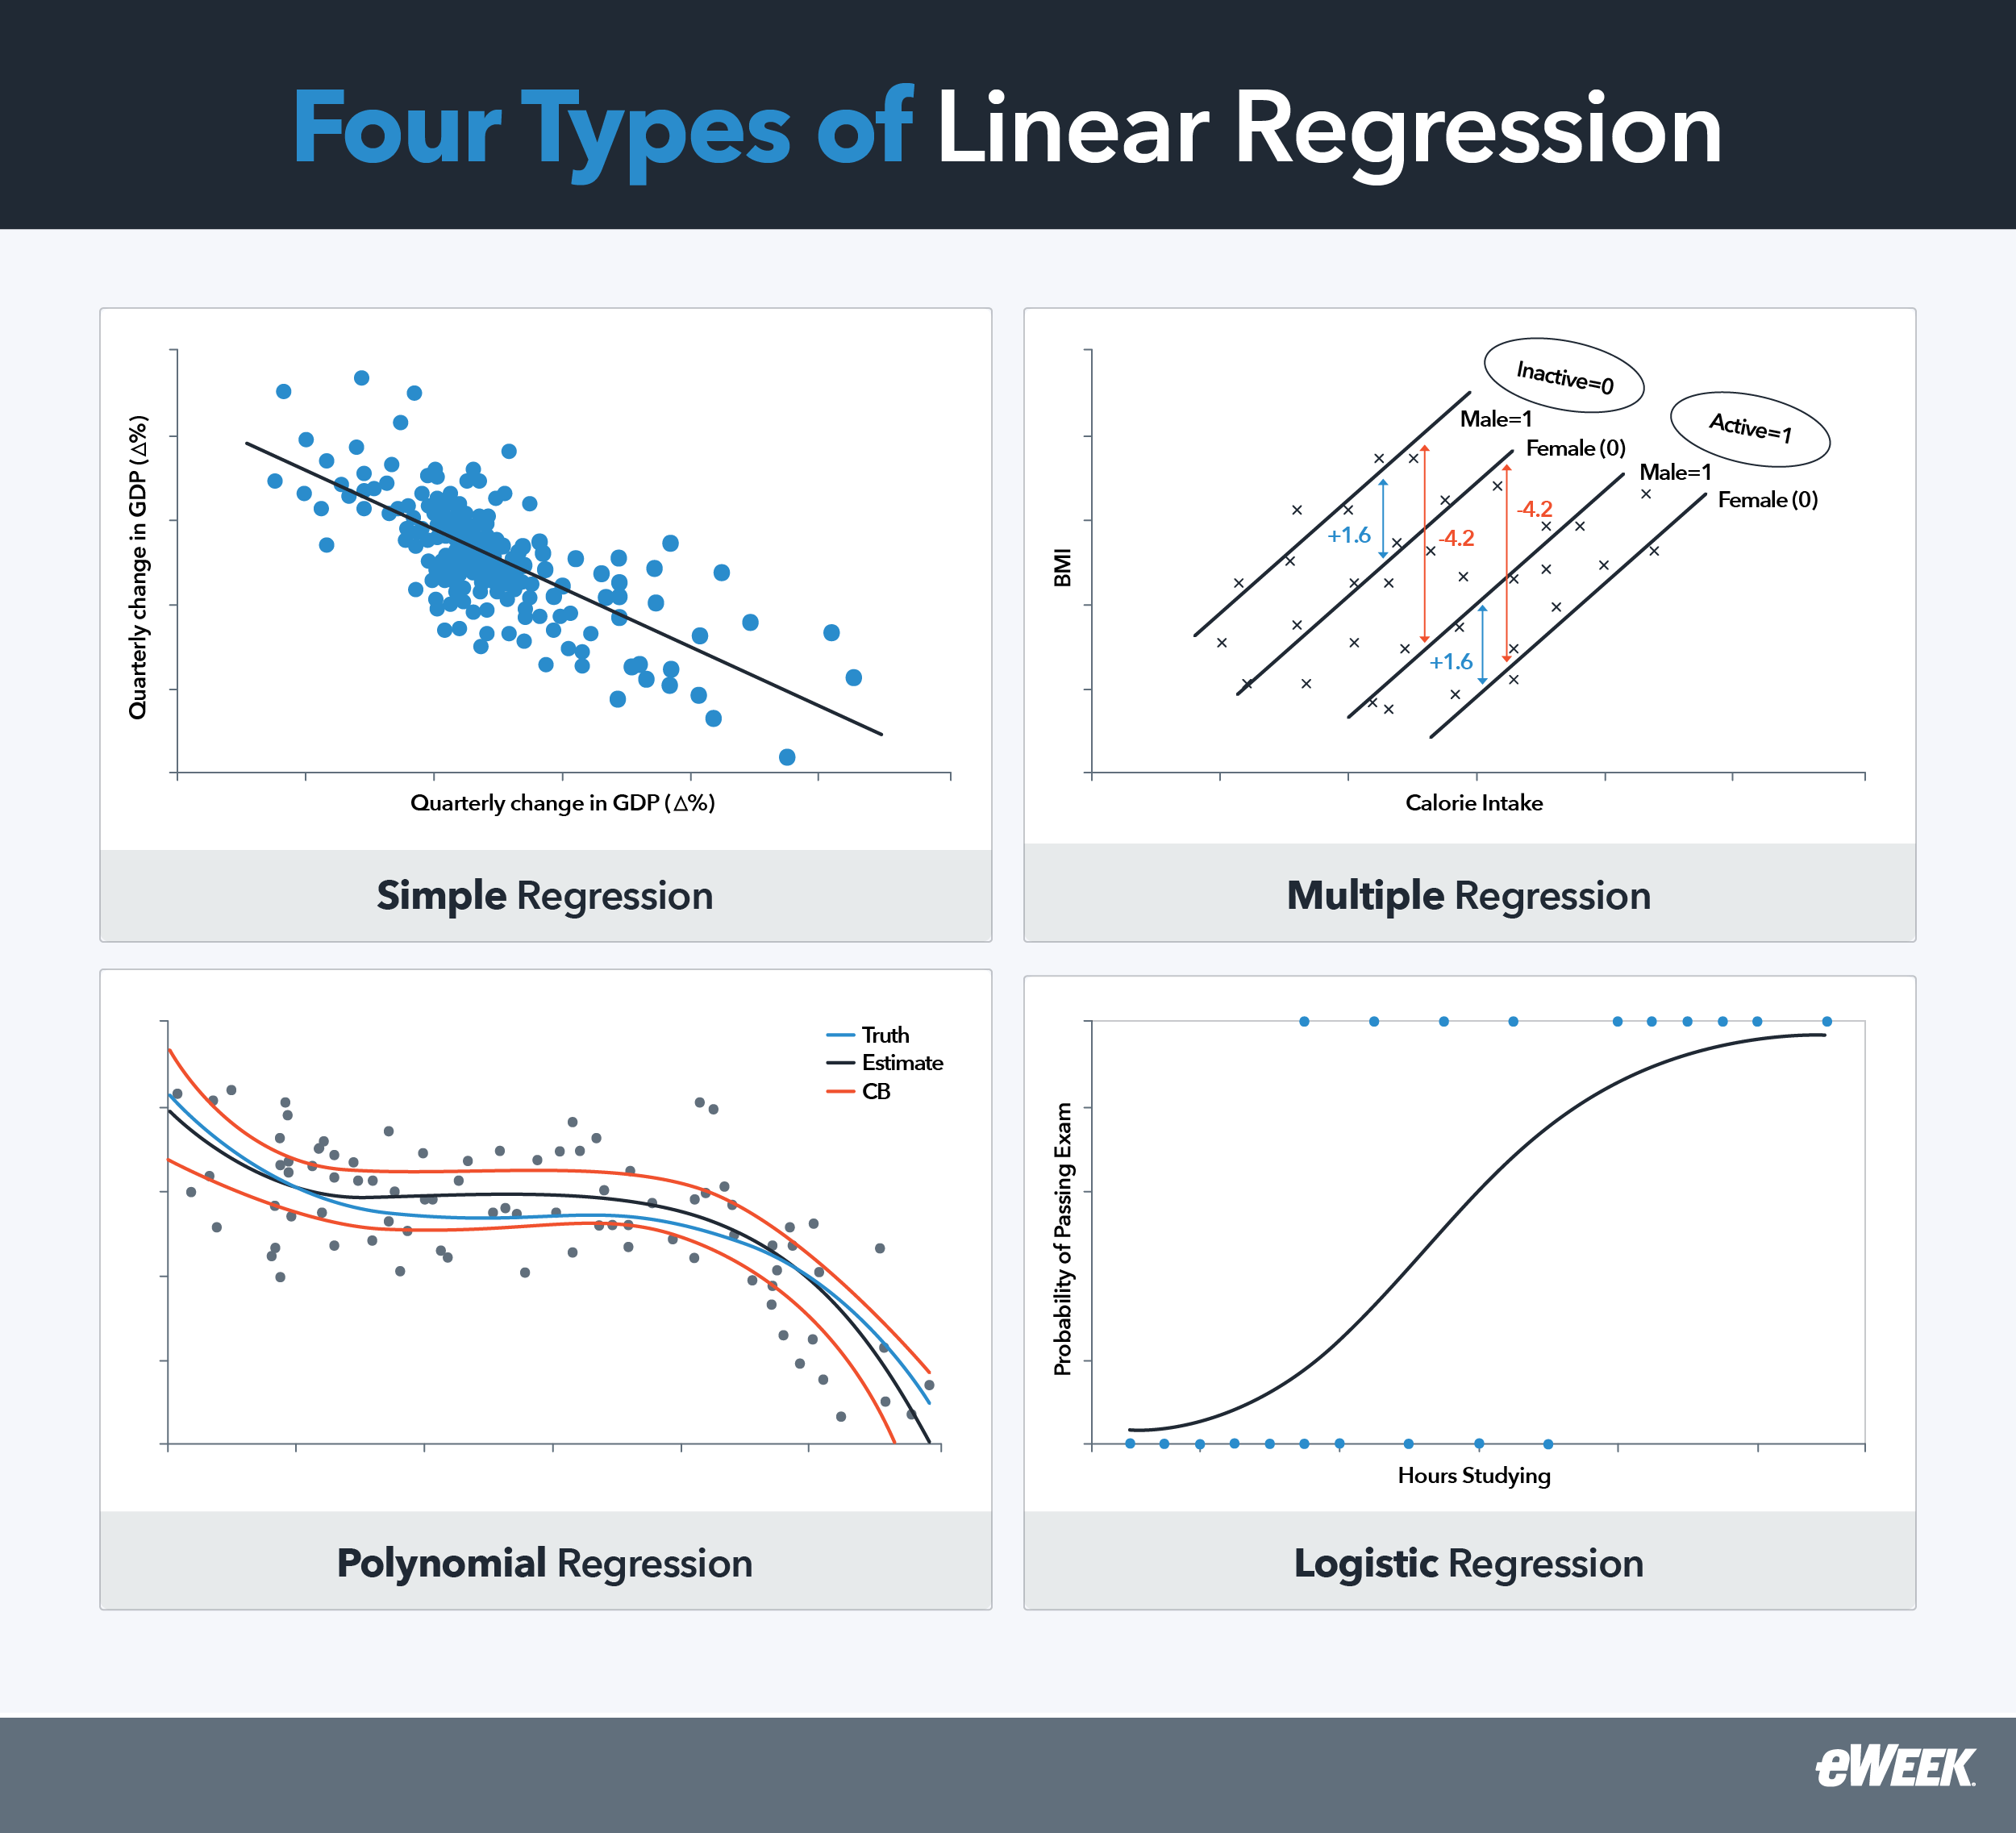
Die vier häufigsten Arten der linearen Regression sind die einfache, die multiple und die polynomiale Regression. Wenn Sie ihre Unterschiede verstehen, können Sie bestimmen, welcher Ansatz am besten zu Ihren Anforderungen passt:
- Einfache lineare Regression: Das grundlegendste lineare Regressionsmodell beschreibt die Korrelation zwischen einer unabhängigen und einer abhängigen Variable. Dazu verwendet es eine Regressionslinie, die die lineare Beziehung zwischen den beiden Variablen veranschaulicht.
- Multiple lineare Regression: Die multiple lineare Regression beschreibt die Korrelation zwischen zwei oder mehr unabhängigen Variablen und einer abhängigen Variable, ebenfalls mithilfe einer geraden Regressionslinie.
- Polynomiale Regression und andere Varianten: Die polynomiale Regression stellt die Beziehung zwischen der abhängigen und den unabhängigen Variablen als Polynom n-ten Grades dar, beispielsweise ax². Bei dieser Form ist die Regressionslinie gekrümmt statt gerade.
- Logistische Regression: Die logistische Regression nutzt die unabhängigen Variablen, um die Wahrscheinlichkeit des Eintretens eines Ereignisses zu schätzen (entweder 0 oder 1). Anstatt eine kontinuierliche Größe oder Zahl vorherzusagen, kategorisiert diese Art der Regressionsanalyse Eingabedaten in vordefinierte Gruppen oder Klassen. Wie der Name schon andeutet, verwendet die logistische Regression logarithmische Funktionen zur Berechnung der Regressionslinie.
Wichtige Annahmen und Einschränkungen der linearen Regression
Die lineare Regression beruht auf mehreren Annahmen, die als Richtlinien für ihre Möglichkeiten dienen. In vielen Fällen lassen sich Verstöße gegen Modellannahmen leicht erkennen, indem verschiedene Diagramme erstellt und visuell überprüft werden. So können Sie beispielsweise die Linearität anhand des Regressionsdiagramms überprüfen: Wenn eine Kurve erkennbar ist, ist die Beziehung zwischen den Variablen möglicherweise nicht linear. Ausreißer im Datensatz lassen sich bei einem kleinen Datensatz ebenfalls einfach durch einen Blick auf das entsprechende Diagramm erkennen.
Andere Verstöße gegen Modellannahmen erfordern möglicherweise eine eingehendere visuelle Analyse oder andere Diagrammtypen. Um beispielsweise auf Homoskedastizität zu prüfen, können Sie Residuen gegen angepasste Werte auftragen. Wenn sich die Residuen auffächern oder zusammenlaufen und dabei eine zunehmende oder abnehmende Streuung zeigen, ist der Datensatz wahrscheinlich nicht homoskedastisch.
Linearität und Unabhängigkeit der Beobachtungen
Die lineare Regression setzt voraus, dass zwischen den unabhängigen und abhängigen Variablen eine lineare Beziehung besteht. Datenfachleute treffen diese Einschätzung typischerweise mithilfe eines Streudiagramms – einer beliebigen Sammlung von x- und y-Datenpunkten –, um zu prüfen, ob die Daten entlang einer geraden Linie liegen.
Homoskedastizität und Normalverteilung der Residuen
Die lineare Regression setzt außerdem voraus, dass die Varianzen der verglichenen Gruppen gleich oder ähnlich sind. Dies ist entscheidend für die Genauigkeit der Regressionsanalysen. Um die Genauigkeit der Vorhersage zu messen, verwenden Datenfachleute die Normalverteilung der Residuen. Das bedeutet, dass sie die Differenz zwischen den beobachteten Daten und dem vorhergesagten Wert messen, um sicherzustellen, dass diese normalverteilt sind.
Keine Multikollinearität
Multikollinearität bezeichnet eine problematische Situation, in der die unabhängigen Variablen eines Regressionsmodells korreliert sind. Sind die unabhängigen Variablen in einer linearen Regression stark korreliert, kann es zu Problemen bei der Modellanpassung und zu Vorhersagefehlern kommen – im Wesentlichen steigt dann der Standardfehler der Koeffizienten.
Nichtlineare Beziehungen
Die logistische Regression wurde zuvor als Möglichkeit zur Vorhersage der Klassenzugehörigkeit vorgestellt. Dafür müssen Modelle so angepasst werden, dass sie die Krümmung in den Datensätzen erfassen. Die Anwendung logarithmischer, Quadratwurzel- oder Kehrwerttransformationen auf die unabhängigen und/oder abhängigen Variablen verändert die Vorhersage effektiv von kontinuierlichen zu diskreten Werten.
Ausreißer und Anomalien
Jeder umfangreiche Datensatz enthält zwangsläufig Ausreißer und Anomalien. Auch wenn der erste Impuls darin besteht, sie zu entfernen, sollten Sie sie nicht einfach verwerfen, wenn sie sich nicht auf einen Fehler zurückführen lassen. Durch ihre Entfernung kann unnötig eine Verzerrung in Ihre Datenwissenschaft eingebracht und die Genauigkeit Ihrer Vorhersagen verringert werden. Behandeln Sie Ausreißer stattdessen mit Methoden wie der quantilbasierten Begrenzung nach unten und oben – dabei werden Ausreißer auf einen bestimmten Wert oberhalb des 90. Perzentils gedeckelt oder auf einen Faktor unterhalb des 10. Perzentils begrenzt – oder der Imputation mit Mittelwert oder Median, bei der die Ausreißer durch den Medianwert ersetzt werden.
Anwendungen der linearen Regression in verschiedenen Bereichen
Unternehmen aus vielen Branchen nutzen lineare Regression für eine breite Palette von Anwendungen. Hier sind einige der häufigsten:
- Umsatz- und Markttrends vorhersagen: Prognosen in Wirtschaft und Ökonomie umfassen den Einsatz linearer Regression zur Analyse abhängiger und unabhängiger Variablen, um zukünftige Umsatzzahlen vorherzusagen.
- Krankheitsmuster analysieren: Fachkräfte im Gesundheitswesen nutzen lineare Regression, um Beziehungen zwischen Patientenfaktoren und Krankheitsverläufen zu bestimmen und dadurch die Patientenversorgung und die klinische Praxis zu verbessern. So können Ärzte beispielsweise anhand klinischer Messwerte, Behandlungsdaten und demografischer Patientendaten die Dauer eines Krankenhausaufenthalts vorhersagen.
- Verhaltenstrends verstehen: In den Sozialwissenschaften und der Bildung wird lineare Regression häufig eingesetzt, um Ursache-Wirkungs-Beziehungen in gesellschaftlichen und demografischen Gruppen, bei Lernenden und bei Medienkonsumenten zu verstehen. So können Forschende beispielsweise mithilfe der linearen Regression Social-Media-Trends, Beziehungen zwischen verschiedenen Variablen und deren Auswirkungen auf das menschliche Verhalten analysieren – etwa den Zusammenhang zwischen der Zahl der online verbrachten Stunden und der Arbeitszufriedenheit.
Software für lineare Regression
Der Markt bietet zahlreiche Tools und KI-gestützte Software , mit denen Sie lineare Regressionsanalysen auf Daten durchführen und diese zur besseren Verständlichkeit visualisieren können. Wir empfehlen Alteryx, IBM SPSS und SAS.
Alteryx
Alteryx ist eine beliebte KI-Analyseplattform, die von Datenexperten genutzt wird, um schnell auf Daten zuzugreifen, sie zu bearbeiten, zu analysieren und auszugeben. Die Designer-Plattform des Unternehmens bietet ein Tool für lineare Regression, mit dem sich einfache Modelle zur Schätzung von Werten oder zur Bewertung von Beziehungen zwischen Variablen auf Grundlage ihrer linearen Korrelationen erstellen lassen. Alteryx Designer Cloud startet bei 4.950 US-Dollar, während Designer Desktop ab 5.195 US-Dollar erhältlich ist.
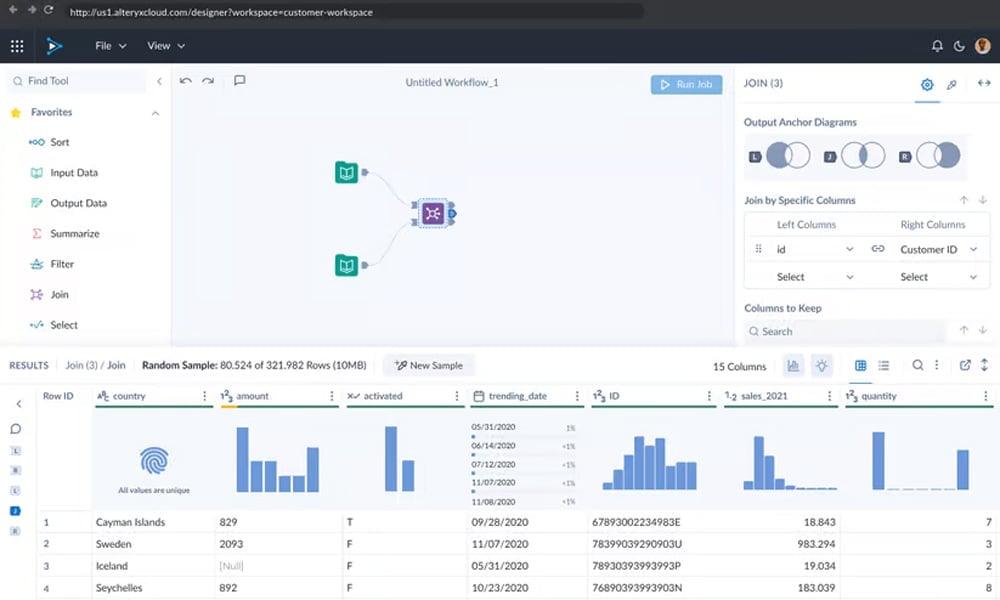
Alteryx Designer.
IBM SPSS
IBM SPSS ist seit Langem bei Datenexperten beliebt, die statistische Analysen und multivariate statistische Verfahren wie die lineare Regression durchführen. Das Softwarepaket SPSS Statistics ermöglicht Nutzern aller Erfahrungsstufen die Durchführung fortgeschrittener statistischer Analysen. Die Preise hängen von den Funktionen und der Zahl der Nutzer ab, aber das Basisabonnement startet für einen Nutzer bei 1.069 US-Dollar pro Jahr.
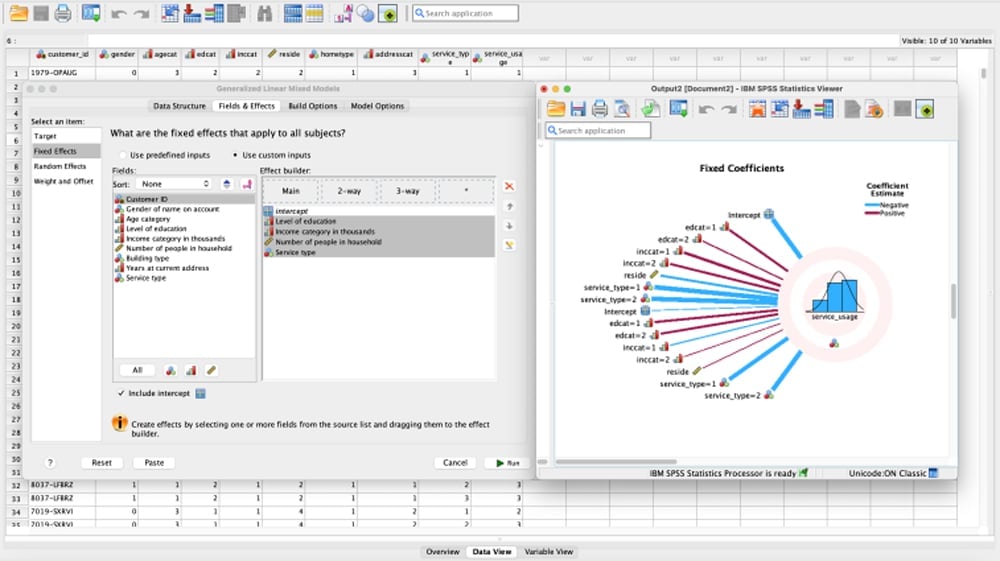
IBM SPSS Statistics.
SAS
Neben IBM SPSS ist SAS ein weiterer etablierter Gigant in der statistischen Analyse und Datenanalyse. Das SAS-System bietet zahlreiche Regressionsverfahren, darunter REG für Regressionen allgemeiner Art. Das Unternehmen veröffentlicht keine Preise, aber die gemeldeten Preisspannen variieren je nach Funktionen, Nutzern und Zusatzoptionen erheblich.
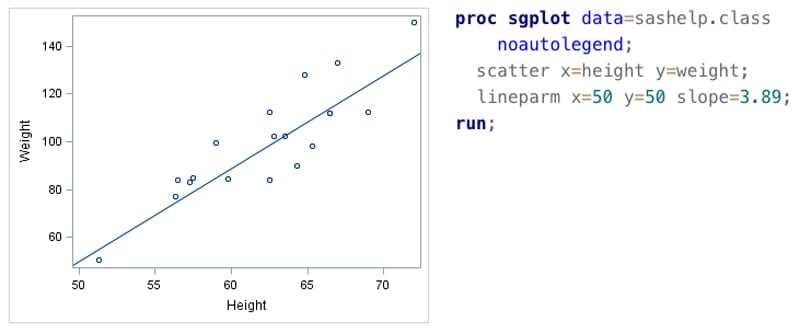
Ein Regressionsdiagramm in SAS.
Häufige Herausforderungen und Lösungen bei der linearen Regression
Lineare Regression ist ein komplexer Prozess, der viele positive Ergebnisse liefern kann, aber auch Herausforderungen für diejenigen mit sich bringt, die ihn implementieren möchten. Hier werfen wir einen Blick auf die häufigsten Herausforderungen und einige Lösungen.
Überanpassung und Unteranpassung begegnen
Überanpassung tritt auf, wenn ein Modell mit überflüssigen Parametern zu komplex ist und die Stichprobengröße für aussagekräftige Vorhersagen zu klein ist. Dies führt zu ML-Modellen, die sich nicht gut auf neue Daten verallgemeinern lassen. Die naheliegendste Möglichkeit, eine Überanpassung zu verringern, besteht darin, einfach mehr Daten zu erfassen, um die Modellgenauigkeit zu verbessern. Unteranpassung tritt dagegen auf, wenn das ML-Modell nicht komplex genug ist und Beziehungen und Muster in den Daten nicht erkennen kann. In diesen Fällen können Sie die Modellkomplexität erhöhen, indem Sie die Zahl der Merkmale im Datensatz steigern.
Statistische Methoden kombinieren
Für einige Anwendungsfälle der Datenanalyse müssen Sie eine kontinuierliche Größe oder Zahl sowie die Zugehörigkeit zu einer diskreten Klasse vorhersagen. In diesen Szenarien besteht ein gängiger Ansatz darin, sowohl ein lineares Regressionsmodell als auch ein logistisches Klassifikationsmodell mit demselben Datensatz zu entwickeln und sie sequenziell einzusetzen. Alternativ könnten Sie ein Modell mit mehreren Ausgaben entwickeln – ein einzelnes neuronales Netzwerkmodell zur Vorhersage sowohl einer kontinuierlichen Größe als auch eines klassenbasierten Labelwerts aus derselben Eingabe.
Prädiktive Modelle verbessern
Obwohl lineare Regression für ihre Einfachheit und Interpretierbarkeit bekannt ist, kann sie bei der Einbeziehung mehrerer Prädiktoren zur Erfassung komplexer Beziehungen auch kompliziert und unübersichtlich werden. Dies könnte zu einer Überanpassung führen und die Fähigkeit Ihres Modells beeinträchtigen, sich auf neue Daten zu verallgemeinern. Um diese Probleme zu mindern und Ihre prädiktiven Modelle zu verbessern, können Sie Regularisierungstechniken wie die Ridge- oder Lasso-Regression einsetzen, um die Leistung zu steigern, Überanpassung zu begegnen und sicherzustellen, dass Ihre linearen Regressionsmodelle robust bleiben und sich gut auf neue Daten verallgemeinern lassen.
Modelle verbessern und validieren
Wie alle prädiktiven Modelle sollten auch Ihre linearen Regressionsmodelle kontinuierlich bewertet und angepasst werden, damit Ihre Vorhersagen genau bleiben. Sie können die Leistung und Wirksamkeit Ihres Regressionsmodells anhand verschiedener quantitativer Größen und Bewertungsmetriken beurteilen. Mithilfe von Bewertungsmetriken wie dem mittleren absoluten Fehler (MAE), dem mittleren quadratischen Fehler (MSE), der Wurzel des mittleren quadratischen Fehlers (RMSE), dem mittleren absoluten prozentualen Fehler (MAPE) und dem symmetrischen mittleren absoluten prozentualen Fehler (SMAPE) können Sie die numerische Distanz zwischen Ihren tatsächlichen und vorhergesagten Werten effektiv messen.
Fazit: Die Möglichkeiten der linearen Regression ausschöpfen
Lineare Regression ist ein unkomplizierter, zuverlässiger Ansatz für die prädiktive Analyse, der weiterhin als Eckpfeiler der modernen Datenwissenschaft und KI/ML dient. Trotz der Vielzahl leistungsfähiger ML-Entwicklungen und -Techniken der vergangenen Jahre verlassen sich Datenexperten bei Vorhersagen zunehmend auf diese einfache und bewährte Methode.
Mehr über die großen Sprachmodelle, die künstliche Intelligenz antreiben erfahren Sie in unserem Leitfaden zu LLMs.