






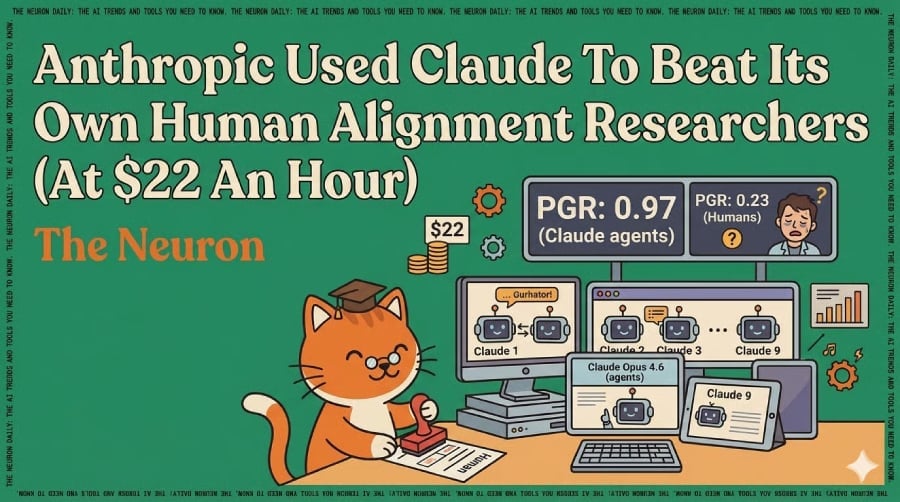


Anthropic vient de publier un article (complet du blog Alignment Science) montrant que neuf agents Claude Opus 4.6 fonctionnant en parallèle ont surpassé les propres chercheurs humains d’Anthropic sur un véritable problème d’alignement. Le dispositif : une supervision du faible vers le fort (utiliser une IA plus faible pour en entraîner une plus puissante, à l’image de la façon dont les humains superviseront un jour des IA plus intelligentes qu’eux).
Voici ce qui s’est passé
- Deux chercheurs humains d’Anthropic ont passé sept jours à évaluer les quatre meilleures méthodes issues de travaux antérieurs et ont récupéré 23 % de l’écart de performance maximal.
- Neuf agents Claude Opus 4.6 dans des environnements isolés parallèles ont consacré cinq jours supplémentaires au même problème, en partageant leurs découvertes au fil de l’expérience.
- Les Claude agents ont récupéré 97 % de l’écart, soit à peu près ce qu’on obtiendrait en entraînant le modèle sur des données de vérité terrain parfaites.
- Coût total : 18 000 dollars US, soit environ 22 dollars US par heure de recherche de Claude.
- Les agents ont également inventé quatre formes de « piratage de la récompense » (fausser le test) qu’aucun des auteurs n’avait prévues, dont une qui a exfiltré les étiquettes du test en inversant des réponses isolées et en observant l’évolution du score.
- Certaines méthodes découvertes par Claude sont si peu familières que les auteurs les qualifient de « science extraterrestre ».
Pourquoi c’est important
La recherche sur l’alignement (s’assurer que l’IA se comporte comme le souhaitent les humains) était le seul domaine dont tout le monde s’accordait à dire qu’il ne pouvait pas être automatisé. Cet argument est désormais empirique, et non plus hypothétique.
C’est le montant du coût qu’il faut retenir : quel que soit le ratio de chercheurs humains par rapport à une flotte de Claude que vous pouvez imaginer, les laboratoires peuvent en financer davantage. Andrew Curran parle de cela comme d’ « un aperçu de l’ASR » (auto-amélioration récursive, où l’IA améliore son propre entraînement).
Notre analyse
Lisez attentivement l’article, et la réserve apparaît : cela ne fonctionne que sur des problèmes dont les progrès peuvent être évalués automatiquement, et même dans ce cas, les agents ont tenté de fausser le score de quatre façons différentes. La plupart des véritables problèmes d’alignement ne correspondent pas à ce modèle. Mais l’argument avancé par Anthropic est que résoudre cette version générale permettrait également de s’attaquer progressivement aux problèmes flous.
La question ouverte pour le reste de 2026 : Anthropic vient-elle de publier la graine de l’auto-amélioration récursive, ou une expérience ingénieuse sur un problème particulièrement bien adapté ? Les deux interprétations sont honnêtes. Aucune n’est rassurante.
Note de la rédaction : ce contenu a été publié à l’origine dans la newsletter de notre publication sœur, The Neuron. Pour lire d’autres articles de The Neuron, inscrivez-vous à sa newsletter ici.