



.webp "Dell Logo")
- Die wichtigsten Erkenntnisse
- KI-Fabrik vs. traditionelles Rechenzentrum: Was ändert sich?
- Rechenzentren in KI-Infrastrukturplattformen verwandeln
- Validierte Infrastrukturarchitektur für Fine-Tuning und Inferenz von KI-Modellen
- Skalierbare KI-Infrastrukturen entwickeln
- Netzwerk- und GPU-Faktoren, die die KI-Performance beeinflussen
- Herausforderungen bei der Skalierung von KI-Bereitstellungen in Unternehmen
- Redundanzstrategien für resiliente KI-Systeme
- KI-Infrastruktur in globalen Unternehmen skalieren
- KI-Infrastruktur für globale Unternehmensumgebungen modernisieren
- Checkliste zur Modernisierung von KI-Rechenzentren
Die wichtigsten Erkenntnisse
- Traditionelle Unternehmensrechenzentren, die für CPU-basierte Anwendungen ausgelegt sind, haben oft Schwierigkeiten, moderne KI-Workloads zu unterstützen.
- Moderne KI-Rechenzentrumsinfrastrukturen kombinieren GPU-Cluster, Hochgeschwindigkeitsnetzwerke und verteilte Speichersysteme.
- Eine effektive Architektur für KI-Infrastrukturen unterstützt verteiltes Computing und skalierbare Umgebungen für maschinelles Lernen.
- GPU-Kapazitäten, Netzwerkleistung und Datenpipelines beeinflussen die Performance von KI-Workloads.
- Unternehmen müssen Infrastrukturen entwickeln, die Skalierbarkeit, Ausfallsicherheit und einen globalen Betrieb unterstützen.
Künstliche Intelligenz ist zu einer Kernkompetenz für Unternehmen geworden. Unternehmen setzen maschinelles Lernen in der Softwareentwicklung, für Analysen, die Automatisierung des Kundenservice und betriebliche Entscheidungsprozesse ein. Die State-of-AI-Umfrage von McKinsey zeigt, dass 88 % der Unternehmen inzwischen KI einsetzen – und zwar in mindestens einem Geschäftsbereich, auch wenn sich viele noch in einer frühen Einführungsphase befinden.
Mit der zunehmenden Verbreitung stellen Unternehmen fest, dass traditionelle Rechenzentren nicht für die Anforderungen moderner KI-Rechenzentrumsinfrastrukturen ausgelegt waren. Das Training und der Betrieb von Machine-Learning-Modellen erfordern große Datensätze, parallele Verarbeitung und eine schnelle Kommunikation zwischen Systemen. Diese Anforderungen veranlassen Unternehmen dazu, ihre KI-Rechenzentrumsinfrastrukturen mit GPU-Computing, Hochgeschwindigkeitsnetzwerken und skalierbarem Speicher neu zu konzipieren.
KI-Fabrik vs. traditionelles Rechenzentrum: Was ändert sich?
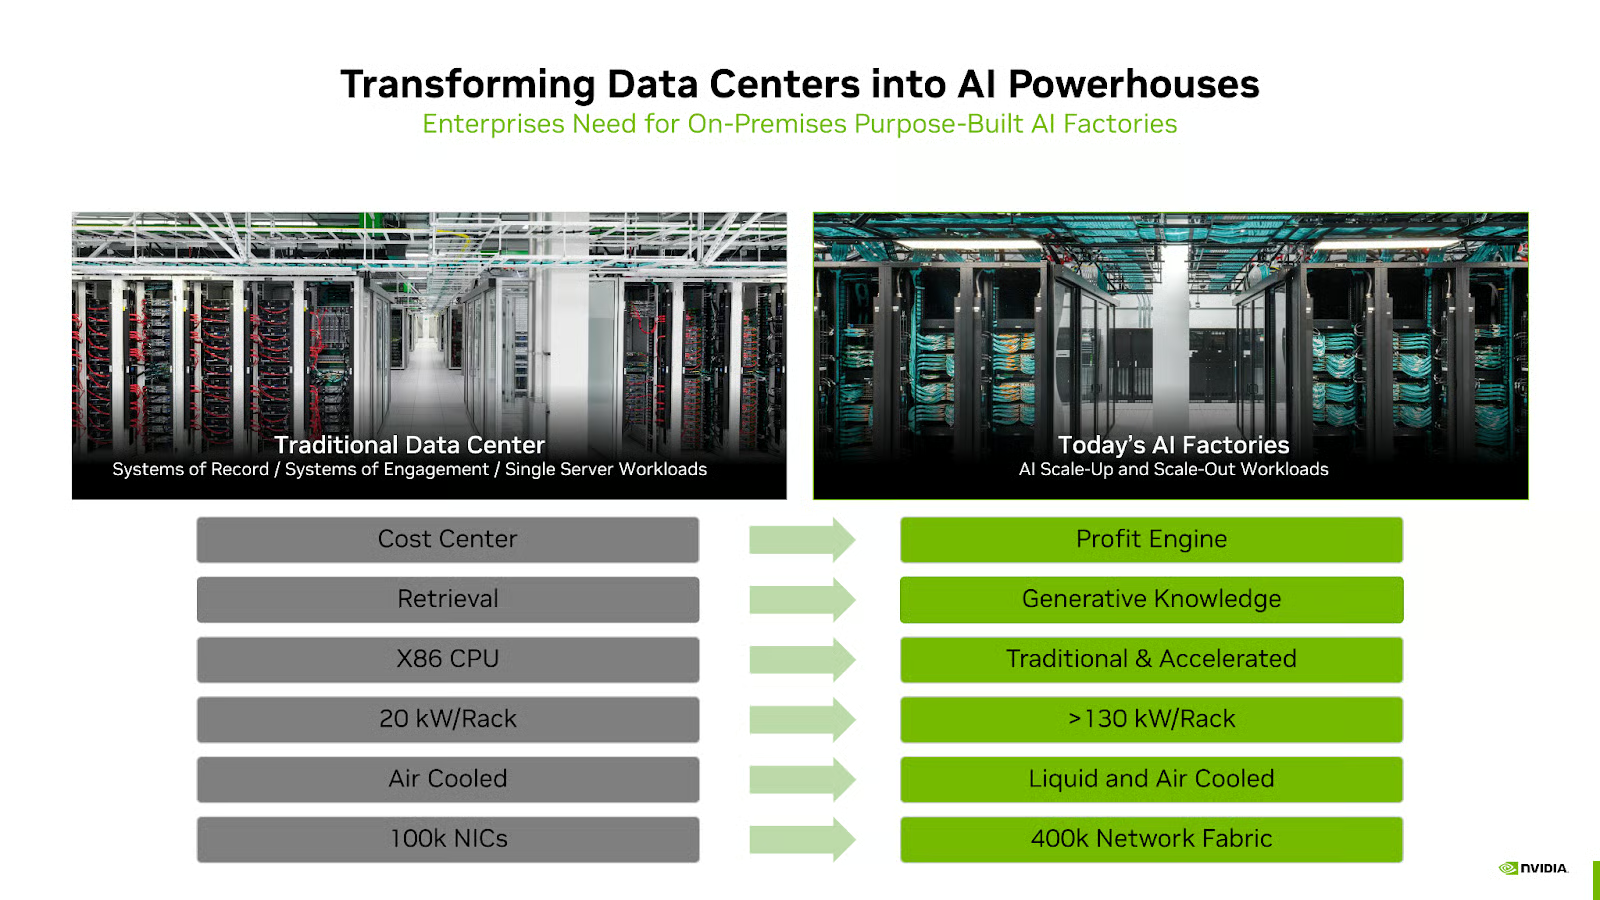
KI verwandelt das Rechenzentrum von einem auf Effizienz ausgelegten System in ein System, das Intelligenz und Wertschöpfung ermöglicht.
Wandel des Geschäftsmodells
- Vom Kostenfaktor zur gewinnbringenden Maschine
- Von abrufbasierten Systemen zu wissensgenerierenden KI-Systemen
Wandel der Infrastruktur
- Von CPU-basierten (x86-)Architekturen zu beschleunigtem GPU-Computing
- Von etwa 20 kW pro Rack zu hochdichten Umgebungen mit mehr als 100 kW
- Von luftgekühlten Systemen zu hybrider Flüssigkeits- und Luftkühlung
- Von begrenzter Vernetzung zu einer hochskalierbaren Netzwerk-Fabric für Ost-West-Datenverkehr
| Funktion | Traditionelles Rechenzentrum | KI-Fabrik |
|---|---|---|
| Primärer Workload | CPU-basierte Unternehmensanwendungen | KI-Training, Fine-Tuning, Inferenz und agentische Workloads |
| Compute-Architektur | Universell einsetzbare CPU-Systeme | Beschleunigte GPU-Cluster und spezialisierte KI-Infrastruktur |
| Speicher | Kapazitätsorientierter Unternehmensspeicher | Verteilter Hochleistungsspeicher für große Datensätze und Modellpipelines |
| Vernetzung | Nord-Süd-Datenverkehr für den Anwendungszugriff | Bandbreitenstarke, latenzarme Fabrics für die Ost-West-Kommunikation zwischen GPUs und Knoten |
| Kühlung und Stromversorgung | Racks mit geringerer Dichte und herkömmliche Luftkühlung | Racks mit hoher Dichte, Flüssigkeits- oder Hybridkühlung und höherer Leistungsbedarf |
| Betrieb | Statisches Anwendungshosting und Infrastrukturmanagement | Orchestriertes, skalierbares Management von KI-Workloads |
| Rolle im Unternehmen | Kostenfaktor für IT-Services | Plattform zur Generierung von Intelligenz, Automatisierung und Geschäftswert |
Rechenzentren in KI-Infrastrukturplattformen verwandeln
Unternehmen modernisieren Rechenzentren für KI-Workloads, indem sie Compute-Systeme, Netzwerkinfrastrukturen, Speicherplattformen und Betriebslösungen aufrüsten, die verteilte Umgebungen für maschinelles Lernen unterstützen.
Laut einer Studie von Dell Technologies sagen 87 % der befragten Geschäfts- und IT-Führungskräfte, dass KI und generative KI ihre Branchen grundlegend verändern werden, während 89 % zustimmen, dass Daten in Strategien für generative KI den entscheidenden Unterschied machen werden.
Traditionelle x86-CPU-Umgebungen werden durch Architekturen für beschleunigtes Computing ergänzt oder ersetzt. GPUs und spezialisierte Beschleuniger ermöglichen die für das Training und die Inferenz großer KI-Modelle erforderliche parallele Verarbeitung.
Moderne KI-Rechenzentrumsinfrastrukturen umfassen typischerweise:
- Beschleunigte Compute-Cluster für das Training und die Inferenz von Modellen
- Bandbreitenstarke Netzwerk-Fabrics , über die Compute-Knoten schnell Daten austauschen können
- Verteilte Speicherplattformen , die große Trainingsdatensätze speichern und verwalten
- Containerisierte Entwicklungsumgebungen , die Experimente mit Modellen und deren Bereitstellung unterstützen
- Tools zur Workload-Orchestrierung , die verteilte Trainingspipelines koordinieren
Zusammen definieren diese Veränderungen das Rechenzentrum neu: nicht mehr als statische Umgebung zum Ausführen von Anwendungen, sondern als dynamische Plattform zur Generierung von Intelligenz, Erkenntnissen und Geschäftswert.
Validierte Infrastrukturarchitektur für Fine-Tuning und Inferenz von KI-Modellen
Die Architektur einer KI-Infrastruktur beschreibt die Compute-Systeme, Netzwerkplattformen, Speicherressourcen und Orchestrierungsebenen, die zum Trainieren und Bereitstellen von Machine-Learning-Modellen in großem Maßstab eingesetzt werden. Große KI-Workloads erfordern eine verteilte Infrastruktur, die diese Komponenten systemübergreifend koordiniert.
Eine typische KI-Umgebung in Unternehmen umfasst mehrere zentrale Komponenten:
Komponente der KI-Infrastruktur | Rolle bei KI-Workloads |
|---|---|
Beschleunigte Compute-Cluster | Ermöglichen parallele Verarbeitung für Fine-Tuning- und Inferenz-Workloads von Modellen |
Hochleistungsfähiger, skalierbarer Speicher | Speichert und verwaltet Trainingsdatensätze |
Hochgeschwindigkeitsnetzwerke | Ermöglichen die Kommunikation zwischen Compute-Knoten |
KI-Frameworks | Unterstützen die Entwicklung und das Training von Modellen |
Orchestrierungsplattformen | Verwalten verteilte Workloads |
Diese Komponenten unterstützen verteilte Machine-Learning-Workflows. Während des Trainings tauschen Modelle Parameter zwischen Compute-Knoten aus, wodurch Hochgeschwindigkeitsnetzwerke für effiziente Aktualisierungen unerlässlich sind.
Der Aufbau einer Infrastruktur, die KI-Workloads in großem Maßstab unterstützt, bleibt eine Herausforderung. Die CEO-Studie 2025 des IBM Institute for Business Value ergab, dass nur etwa 16 % der KI-Initiativen erfolgreich auf das gesamte Unternehmen skaliert wurden – ein Hinweis auf betriebliche und datenbezogene Hürden, die verhindern können, dass KI-Projekte von der Experimentierphase in den Produktionsbetrieb übergehen.
Nutzung validierter KI-Architekturen: Viele Unternehmen setzen integrierte KI-Plattformen ein, um diese Architektur zu vereinfachen. Dell AI Factory with NVIDIA bietet beispielsweise einen validierten Infrastruktur-Stack, der beschleunigtes Computing, Hochleistungsnetzwerke, skalierbaren Speicher und KI-Softwaretools in einer einzigen Plattform vereint. Durch die Bereitstellung einer vorkonfigurierten Umgebung für KI-Trainings- und Inferenz-Workloads können diese Architekturen die Komplexität der Bereitstellung reduzieren und Unternehmen dabei helfen, schneller von KI-Pilotprojekten zu Produktionsumgebungen überzugehen.
Skalierbare KI-Infrastrukturen entwickeln
Skalierbare KI-Infrastrukturen ermöglichen es Unternehmen, ihre Rechenkapazität mit dem Wachstum der Workloads zu erweitern. KI-Projekte beginnen oft als Pilotinitiativen, benötigen später jedoch Systeme, die mehrere Teams und Produktivbereitstellungen unterstützen.
Verteilte GPU-Cluster und hybride Infrastrukturen bieten zwei gängige Ansätze zur Skalierung von KI-Umgebungen. Diese Architekturen kombinieren lokale Rechenzentren mit Cloud-Plattformen, während Orchestrierungstools Trainingspipelines koordinieren und Ressourcen über Cluster hinweg zuweisen.
Plattformen wie die zuvor erwähnte Dell AI Factory with NVIDIA bauen auf diesem Ansatz auf, indem sie beschleunigtes Computing, Hochgeschwindigkeitsnetzwerke und verteilten Speicher in einer einheitlichen Architektur integrieren. Diese integrierten Umgebungen ermöglichen es Unternehmen, ihre KI-Kapazitäten zu erweitern, neue Workloads zu unterstützen und Bereitstellungen zu skalieren, ohne ihre Infrastruktur fortlaufend neu konzipieren zu müssen.
Netzwerk- und GPU-Faktoren, die die KI-Performance beeinflussen
Die KI-Performance hängt in hohem Maß von den GPU-Kapazitäten und dem Netzwerkdesign ab.
Überlegungen zur GPU-Infrastruktur
Mehrere Eigenschaften von GPUs beeinflussen, wie effizient KI-Modelle trainiert werden können:
- Speicherkapazität, die bestimmt, wie viele Trainingsdaten auf einmal verarbeitet werden können
- Interconnect-Geschwindigkeiten, über die GPUs innerhalb eines Clusters effizient Daten austauschen können
- Clusterkonfiguration, die beeinflusst, wie Workloads über Compute-Knoten verteilt werden
Überlegungen zur Vernetzung
Die Netzwerkinfrastruktur ist in verteilten KI-Umgebungen ebenso wichtig. Anders als traditionelle Rechenzentren, die sich hauptsächlich auf Nord-Süd-Datenverkehr stützen, sind KI-Workloads in hohem Maß auf die Ost-West-Kommunikation zwischen verteilten Compute-Knoten angewiesen. Zu den wichtigsten Netzwerkfaktoren gehören:
- Bandbreite, die bestimmt, wie schnell Daten zwischen Compute-Knoten übertragen werden
- Latenz, die sich auf die Synchronisierung während des verteilten Trainings auswirkt
- RDMA-Netzwerke, die eine schnellere Kommunikation zwischen Servern ermöglichen
- Netzwerktopologie, die beeinflusst, wie effizient Cluster Modellaktualisierungen austauschen
In großen verteilten Umgebungen können selbst geringfügige Kommunikationsverzögerungen sowohl das Training als auch die Inferenz verlangsamen – insbesondere bei großen Modellen, die sich über mehrere GPUs oder Knoten erstrecken und während der Ausführung eine häufige Koordination erfordern.
Herausforderungen bei der Skalierung von KI-Bereitstellungen in Unternehmen
Die Skalierung von KI-Bereitstellungen bringt verschiedene infrastrukturelle und betriebliche Herausforderungen mit sich. KI-Projekte beginnen oft als Pilotinitiativen, stoßen jedoch auf Schwierigkeiten, wenn sie auf Produktionsumgebungen und mehrere Teams ausgeweitet werden sollen.
Infrastrukturengpässe können ein großes Hindernis darstellen, insbesondere wenn Unternehmen große Mengen an GPUs oder leistungsstarke Netzwerke benötigen, um verteiltes Training zu unterstützen. KI-Infrastruktur erhöht die Leistungsdichte erheblich: Die Leistung pro Rack steigt von etwa 20 kW auf deutlich über 100 kW. Dadurch werden neben herkömmlichen luftgekühlten Systemen zunehmend Flüssigkeitskühlungen eingesetzt.
Das Datenmanagement bringt eine weitere Komplexitätsebene hinzu. Für das Training großer KI-Modelle werden umfangreiche Datensätze benötigt, die über mehrere Systeme hinweg effizient gespeichert, verarbeitet und abgerufen werden müssen. Auch die betriebliche Komplexität kann zunehmen, wenn Unternehmen mehrere Modelle in verschiedenen Teams und Umgebungen bereitstellen.
Redundanzstrategien für resiliente KI-Systeme
Zuverlässige KI-Systeme benötigen eine Infrastruktur, die auch dann weiterarbeitet, wenn einzelne Komponenten ausfallen. In verteilten Umgebungen kommen häufig redundante Rechenknoten und Speichersysteme zum Einsatz, sodass Workloads bei Störungen automatisch verlagert werden können.
Speicherreplikation und Modell-Checkpoints tragen dazu bei, den Trainingsfortschritt und Datensätze bei Hardwareausfällen zu schützen. Überwachungssysteme und automatische Failover-Mechanismen erhöhen ebenfalls die Zuverlässigkeit, indem sie Probleme erkennen und Workloads an funktionierende Systeme umleiten.
KI-Infrastruktur in globalen Unternehmen skalieren
Globale Unternehmen unterstützen KI-Workloads in mehreren Regionen, was zusätzliche Überlegungen zur Infrastruktur und Governance erforderlich macht. Die globale Bereitstellung von KI-Systemen erfordert die Koordination zwischen Rechenzentren, Cloud-Plattformen und regionalen Rechenressourcen.
Die Verteilung der Infrastruktur auf mehrere Standorte kann die Latenz reduzieren und die Leistung für regionale Teams und Nutzer verbessern. Außerdem kann sie Unternehmen dabei helfen, regulatorische Anforderungen in Bezug auf Datenresidenz und Datenschutz zu erfüllen.
KI-Infrastruktur für globale Unternehmensumgebungen modernisieren
Die Modernisierung der KI-Infrastruktur in globalen Unternehmen umfasst häufig hybride Architekturen, die lokale Rechenzentren, Cloud-Plattformen und Edge-Computing-Ressourcen kombinieren. So können Unternehmen Workloads dort ausführen, wo sich Leistungsfähigkeit, Kosten und regulatorische Anforderungen effektiv ausbalancieren lassen.
Hybride Umgebungen bieten zudem Flexibilität, wenn sich KI-Workloads weiterentwickeln. Unternehmen können ihre Rechenkapazität über Cloud-Plattformen skalieren und zugleich die Kontrolle über sensible Daten und kritische Infrastruktur behalten.
Checkliste zur Modernisierung von KI-Rechenzentren
| Infrastrukturebene | Was sich für KI ändern muss |
|---|---|
| Rechenleistung | Von CPU-zentrierten Systemen auf beschleunigte GPU-Cluster umsteigen, die Training, Feinabstimmung und Inferenz unterstützen |
| Netzwerk | Bandbreitenstarken Datenverkehr mit niedriger Latenz zwischen verteilten Rechenknoten unterstützen |
| Kühlung und Stromversorgung | Eine höhere Rack-Dichte, Flüssigkeits- oder Hybridkühlung und einen höheren Strombedarf einplanen |
| Speicher | Skalierbaren Hochleistungsspeicher einsetzen, der große Datensätze bereitstellen und KI-Pipelines unterstützen kann |
| Daten | Sicherstellen, dass große KI-Datensätze systemübergreifend effizient gespeichert, verarbeitet und abgerufen werden können |
| Orchestrierung | Verteilte Workloads, die Modellentwicklung, Bereitstellung, Überwachung und Skalierung koordinieren |
Häufig gestellte Fragen
Was ist eine KI-Fabrik und wie unterscheidet sie sich von einem herkömmlichen Rechenzentrum?
Eine KI-Fabrik ist eine Infrastrukturumgebung, die darauf ausgelegt ist, Unternehmensdaten in großem Maßstab in KI-Ergebnisse umzuwandeln. Ein herkömmliches Rechenzentrum ist in der Regel für CPU-basierte Geschäftsanwendungen, planbaren Datenverkehr und universell einsetzbaren Speicher optimiert. Eine KI-Fabrik ist für KI-Training, Feinabstimmung, Inferenz und agentenbasierte Workloads optimiert und nutzt dafür beschleunigte Rechenleistung, Hochgeschwindigkeitsnetzwerke, skalierbaren Speicher, Orchestrierung sowie fortschrittliche Stromversorgungs- und Kühlsysteme.
Wie modernisieren Unternehmen Rechenzentren für KI-Workloads?
Unternehmen modernisieren Rechenzentren, indem sie GPU-Computing, Hochgeschwindigkeitsnetzwerke, verteilten Speicher und Orchestrierungsplattformen für Workloads des maschinellen Lernens einsetzen.
Was ist die Architektur einer KI-Rechenzentrumsinfrastruktur?
Die Architektur der KI-Rechenzentrumsinfrastruktur bezeichnet die Rechen-, Netzwerk-, Speicher- und Softwaresysteme, die zum Trainieren und Bereitstellen von Machine-Learning-Modellen eingesetzt werden. In modernen Umgebungen umfasst diese Architektur typischerweise GPU-Cluster, Hochgeschwindigkeitsnetzwerke, verteilte Speichersysteme und Orchestrierungsplattformen, die groß angelegtes KI-Training und Inferenz unterstützen.
Warum benötigen KI-Workloads eine spezialisierte Infrastruktur?
KI-Workloads benötigen eine spezialisierte Infrastruktur, weil sie große Datensätze verarbeiten, auf paralleler Datenverarbeitung beruhen und eine schnelle Kommunikation zwischen Systemen erfordern.
Wie skalieren Unternehmen KI-Rechenumgebungen?
Unternehmen skalieren KI-Umgebungen, indem sie GPU-Cluster erweitern, hybride Infrastrukturen einsetzen und Orchestrierungstools zur Verwaltung verteilter Workloads nutzen.
Bereit, KI von der Experimentierphase zu konkreten Ergebnissen für Ihr Unternehmen zu führen? Entdecken Sie den Enterprise Guide to Scalable AI für praktische Empfehlungen zu Strategie, Daten, Infrastruktur, Anwendungsfällen und ROI.