



.webp "Dell Logo")
- À retenir
- Usine d’IA ou data center traditionnel : qu’est-ce qui change ?
- Transformer les data centers en plateformes d’infrastructure d’IA
- Architecture d’infrastructure validée pour l’ajustement fin et l’inférence de l’IA
- Concevoir une infrastructure d’IA évolutive
- Les facteurs liés aux réseaux et aux GPU qui influent sur les performances de l’IA
- Les défis de l’évolutivité des déploiements d’IA en entreprise
- Stratégies de redondance pour des systèmes d’IA résilients
- Mettre à l’échelle l’infrastructure d’IA au sein d’organisations internationales
- Moderniser l’infrastructure d’IA pour les environnements d’entreprise internationaux
- Liste de contrôle pour moderniser un centre de données d’IA
À retenir
- Les data centers d’entreprise traditionnels, conçus pour des applications reposant sur des processeurs CPU, peinent souvent à prendre en charge les charges de travail d’IA modernes.
- L’infrastructure moderne des data centers d’IA associe des clusters de GPU, des réseaux haut débit et des systèmes de stockage distribués.
- Une architecture d’infrastructure d’IA efficace prend en charge l’informatique distribuée et les environnements évolutifs de machine learning.
- Les capacités des GPU, les performances réseau et les pipelines de données influent sur les performances des charges de travail d’IA.
- Les entreprises doivent concevoir des infrastructures capables de prendre en charge l’évolutivité, la résilience et les déploiements mondiaux.
L’intelligence artificielle est devenue une capacité essentielle pour les entreprises. Les organisations appliquent le machine learning au développement logiciel, à l’analytique, à l’automatisation du service client et à la prise de décision opérationnelle. L’étude State of AI de McKinsey indique que 88 % des organisations utilisent désormais l’IA dans au moins une fonction métier, même si beaucoup en sont encore aux premières étapes du déploiement.
À mesure que l’adoption progresse, les entreprises découvrent que les data centers traditionnels n’ont pas été conçus pour répondre aux exigences de l’infrastructure moderne des data centers d’IA. L’entraînement et l’exécution de modèles de machine learning nécessitent de vastes jeux de données, un traitement parallèle et des communications rapides entre les systèmes. Ces exigences poussent les entreprises à repenser l’infrastructure de leurs data centers d’IA en misant sur le calcul GPU, les réseaux haut débit et le stockage évolutif.
Usine d’IA ou data center traditionnel : qu’est-ce qui change ?
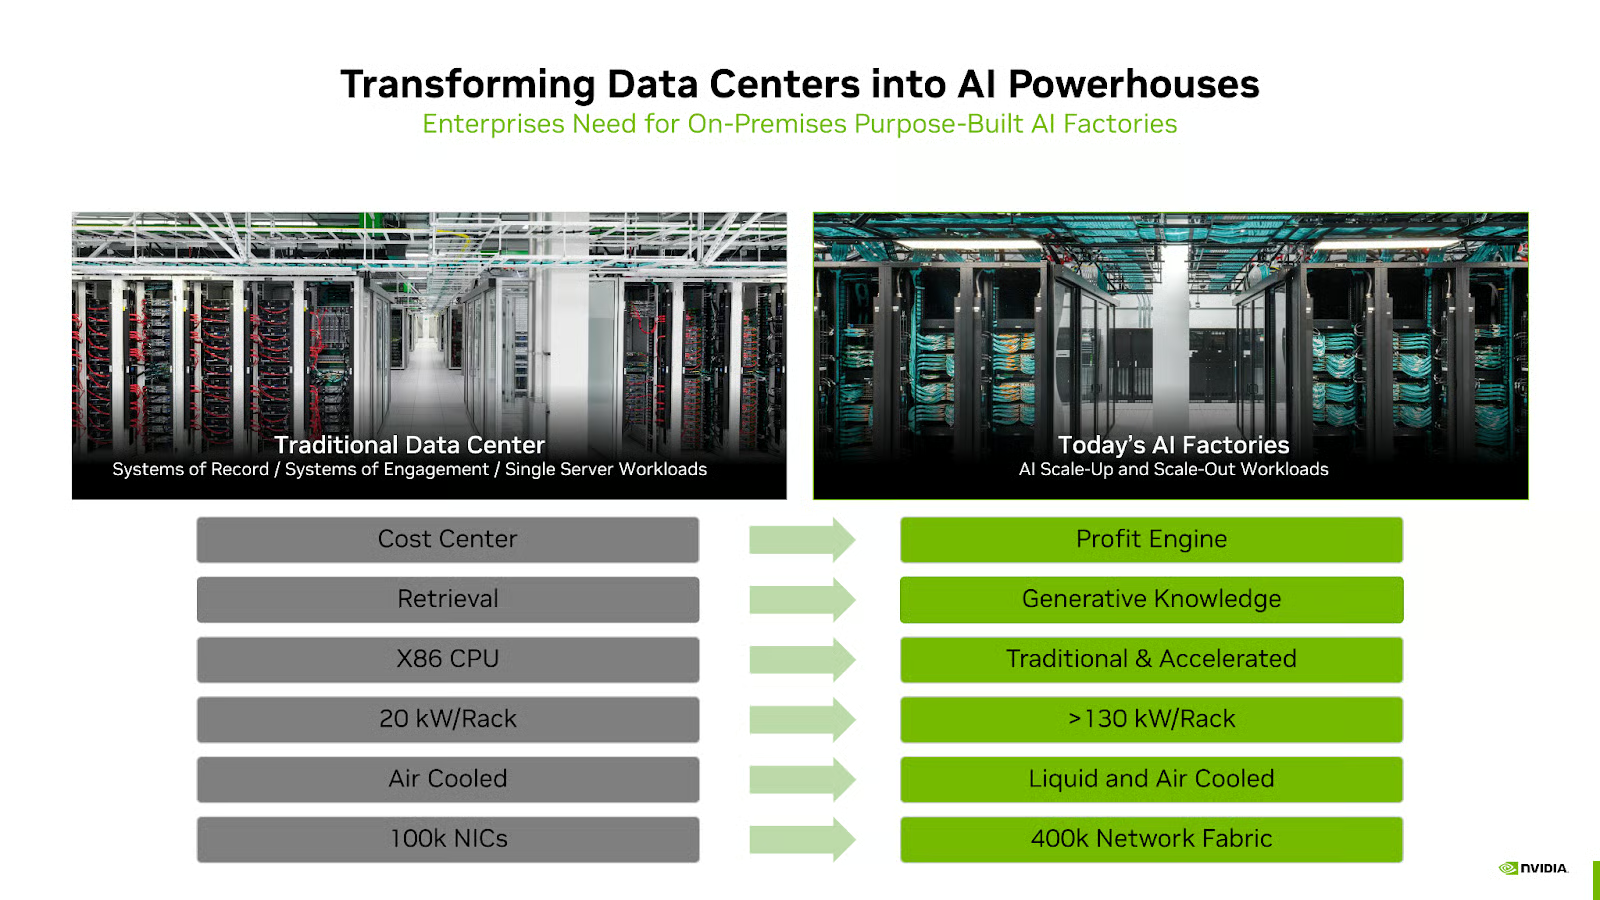
L’IA transforme le data center : d’un système conçu pour l’efficacité, il devient un système conçu pour l’intelligence et la création de valeur.
Évolution du modèle économique
- D’un centre de coûts à un moteur générateur de revenus
- Des systèmes fondés sur la recherche d’informations aux systèmes d’IA générant des connaissances
Évolution de l’infrastructure
- Des architectures reposant sur des CPU (x86) au calcul accéléré par GPU
- D’environ 20 kW par rack à des environnements haute densité de plus de 100 kW
- Des systèmes refroidis par air au refroidissement hybride liquide et à air
- De réseaux limités à une fabric réseau à grande échelle prenant en charge le trafic est-ouest
| Capacité | Data center traditionnel | Usine d’IA |
|---|---|---|
| Charge de travail principale | Applications d’entreprise reposant sur des CPU | Entraînement, ajustement fin, inférence et charges de travail agentiques de l’IA |
| Architecture de calcul | Systèmes CPU polyvalents | Clusters de GPU accélérés et infrastructure d’IA spécialisée |
| Stockage | Stockage d’entreprise axé sur la capacité | Stockage distribué hautes performances pour les grands jeux de données et les pipelines de modèles |
| Réseaux | Trafic nord-sud pour l’accès aux applications | Fabrics à large bande passante et faible latence pour les communications est-ouest entre GPU et nœuds |
| Refroidissement et alimentation | Racks à plus faible densité et refroidissement traditionnel par air | Racks haute densité, refroidissement liquide ou hybride et besoins énergétiques supérieurs |
| Opérations | Hébergement statique des applications et gestion de l’infrastructure | Gestion orchestrée et évolutive des charges de travail d’IA |
| Rôle métier | Centre de coûts pour les services informatiques | Plateforme de génération d’intelligence, d’automatisation et de valeur métier |
Transformer les data centers en plateformes d’infrastructure d’IA
Les entreprises modernisent leurs data centers pour les charges de travail d’IA en mettant à niveau les systèmes de calcul, l’infrastructure réseau, les plateformes de stockage et les outils opérationnels qui prennent en charge les environnements distribués de machine learning.
Selon une étude de Dell Technologies, 87 % des responsables métier et informatiques interrogés affirment que l’IA et l’IA générative transformeront considérablement leurs secteurs, tandis que 89 % estiment que les données seront le principal facteur de différenciation des stratégies d’IA générative.
Les environnements CPU x86 traditionnels sont complétés ou remplacés par des architectures de calcul accéléré. Les GPU et les accélérateurs spécialisés permettent le traitement parallèle nécessaire à l’entraînement et à l’inférence de l’IA à grande échelle.
L’infrastructure moderne des data centers d’IA comprend généralement :
- Des clusters de calcul accéléré pour l’entraînement et l’inférence des modèles
- Des fabrics réseau à large bande passante qui permettent aux nœuds de calcul d’échanger rapidement des données
- Des plateformes de stockage distribué qui stockent et gèrent de vastes jeux de données d’entraînement
- Des environnements de développement conteneurisés qui prennent en charge l’expérimentation et le déploiement des modèles
- Des outils d’orchestration des charges de travail qui coordonnent les pipelines d’entraînement distribués
Ensemble, ces changements redéfinissent le data center : il n’est plus un environnement statique destiné à exécuter des applications, mais une plateforme dynamique dédiée à la génération d’intelligence, d’insights et de valeur métier.
Architecture d’infrastructure validée pour l’ajustement fin et l’inférence de l’IA
L’architecture d’infrastructure d’IA décrit les systèmes de calcul, les plateformes réseau, les ressources de stockage et les couches d’orchestration utilisés pour entraîner et déployer des modèles de machine learning à grande échelle. Les charges de travail d’IA à grande échelle nécessitent une infrastructure distribuée qui coordonne ces composants entre les systèmes.
Un environnement d’IA d’entreprise type comprend plusieurs composants clés :
Composant de l’infrastructure d’IA | Rôle dans les charges de travail d’IA |
|---|---|
Clusters de calcul accéléré | Ils fournissent le traitement parallèle nécessaire aux charges de travail d’ajustement fin et d’inférence des modèles |
Stockage hautes performances et évolutif | Stocker et gérer les jeux de données d’entraînement |
Réseaux haut débit | Permettre la communication entre les nœuds de calcul |
Frameworks d’IA | Prendre en charge le développement et l’entraînement des modèles |
Plateformes d’orchestration | Gérer les charges de travail distribuées |
Ces composants prennent en charge les workflows distribués de machine learning. Pendant l’entraînement, les modèles échangent des paramètres entre les nœuds de calcul, ce qui rend les réseaux haut débit indispensables à l’efficacité des mises à jour.
Construire une infrastructure capable de prendre en charge les charges de travail d’IA à grande échelle reste un défi. L’étude 2025 du IBM Institute for Business Value auprès des PDG a révélé qu’environ 16 % des initiatives d’IA ont été déployées avec succès à l’échelle de l’entreprise, ce qui met en évidence les obstacles opérationnels et liés aux données susceptibles d’empêcher les projets d’IA de passer de l’expérimentation à la production.
Adopter des architectures d’IA validées : De nombreuses entreprises adoptent des plateformes d’IA intégrées pour simplifier cette architecture. Dell AI Factory with NVIDIA, par exemple, fournit une pile d’infrastructure validée qui associe calcul accéléré, réseaux hautes performances, stockage évolutif et outils logiciels d’IA au sein d’une plateforme unique. En proposant un environnement préconçu pour les charges de travail d’entraînement et d’inférence de l’IA, ces architectures peuvent réduire la complexité du déploiement et aider les organisations à passer plus rapidement des projets pilotes d’IA aux environnements de production.
Concevoir une infrastructure d’IA évolutive
Une infrastructure d’IA évolutive permet aux organisations d’accroître leur capacité de calcul à mesure que les charges de travail augmentent. Les projets d’IA commencent souvent par des initiatives pilotes, mais nécessitent ensuite des systèmes capables de prendre en charge plusieurs équipes et des déploiements en production.
Les clusters de GPU distribués et les infrastructures hybrides constituent deux approches courantes pour faire évoluer les environnements d’IA. Ces architectures associent des data centers sur site à des plateformes cloud, tandis que les outils d’orchestration coordonnent les pipelines d’entraînement et allouent les ressources entre les clusters.
Des plateformes comme Dell AI Factory with NVIDIA s’appuient sur cette approche en intégrant calcul accéléré, réseaux haut débit et stockage distribué au sein d’une architecture unifiée. Ces environnements intégrés permettent aux organisations d’accroître leur capacité d’IA, de prendre en charge de nouvelles charges de travail et de faire évoluer leurs déploiements sans devoir repenser constamment leur infrastructure.
Les facteurs liés aux réseaux et aux GPU qui influent sur les performances de l’IA
Les performances de l’IA dépendent largement des capacités des GPU et de la conception du réseau.
Considérations relatives à l’infrastructure GPU
Plusieurs caractéristiques des GPU influent sur l’efficacité de l’entraînement des modèles :
- Capacité mémoire, qui détermine la quantité de données d’entraînement pouvant être traitée simultanément
- Débits des interconnexions, qui permettent aux GPU d’un cluster d’échanger efficacement des données
- Configuration du cluster, qui influe sur la répartition des charges de travail entre les nœuds de calcul
Considérations relatives aux réseaux
L’infrastructure réseau est tout aussi importante dans les environnements d’IA distribués. Contrairement aux data centers traditionnels, qui reposent principalement sur un trafic nord-sud, les charges de travail d’IA dépendent fortement des communications est-ouest entre les nœuds de calcul distribués. Les principaux facteurs réseau sont les suivants :
- Bande passante, qui détermine la vitesse de circulation des données entre les nœuds de calcul
- Latence, qui influe sur la synchronisation pendant l’entraînement distribué
- Réseaux RDMA, qui permettent d’accélérer les communications entre les serveurs
- Topologie réseau, qui influe sur l’efficacité des échanges de mises à jour de modèles entre les clusters
Dans les environnements distribués de grande taille, même de faibles délais de communication peuvent ralentir les performances de l’entraînement et de l’inférence, en particulier pour les grands modèles répartis sur plusieurs GPU ou nœuds et nécessitant une coordination fréquente pendant leur exécution.
Les défis de l’évolutivité des déploiements d’IA en entreprise
La mise à l’échelle des déploiements d’IA soulève plusieurs défis liés à l’infrastructure et aux opérations. Les projets d’IA commencent souvent par des initiatives pilotes, mais rencontrent des difficultés lorsqu’il s’agit de les étendre à l’ensemble des environnements de production et des équipes.
Les contraintes liées à l’infrastructure peuvent constituer un obstacle majeur, en particulier lorsque les organisations ont besoin d’un grand nombre de GPU ou d’un réseau hautes performances pour prendre en charge l’entraînement distribué. L’infrastructure d’IA augmente considérablement la densité de puissance, les racks passant d’environ 20 kW à largement plus de 100 kW, ce qui favorise l’adoption du refroidissement liquide en complément des systèmes traditionnels refroidis par air.
La gestion des données ajoute un niveau de complexité supplémentaire. L’entraînement de grands modèles d’IA nécessite de vastes jeux de données, qui doivent être stockés, traités et consultés efficacement sur plusieurs systèmes. La complexité opérationnelle peut également s’accroître lorsque les organisations déploient plusieurs modèles au sein de différentes équipes et dans divers environnements.
Stratégies de redondance pour des systèmes d’IA résilients
Les systèmes d’IA fiables nécessitent une infrastructure qui continue de fonctionner lorsque certains composants tombent en panne. Les environnements distribués utilisent souvent des nœuds de calcul et des systèmes de stockage redondants afin que les charges de travail puissent basculer automatiquement en cas d’interruption.
La réplication du stockage et la sauvegarde de points de contrôle des modèles contribuent à protéger la progression de l’entraînement et les jeux de données en cas de perturbation matérielle. Les systèmes de surveillance et les mécanismes automatisés de basculement renforcent également la fiabilité en détectant les problèmes et en réacheminant les charges de travail vers des systèmes opérationnels.
Mettre à l’échelle l’infrastructure d’IA au sein d’organisations internationales
Les entreprises internationales prennent en charge les charges de travail d’IA dans plusieurs régions, ce qui soulève des considérations supplémentaires en matière d’infrastructure et de gouvernance. Le déploiement de systèmes d’IA à l’échelle mondiale nécessite une coordination entre les centres de données, les plateformes cloud et les ressources informatiques régionales.
La répartition de l’infrastructure sur plusieurs sites peut réduire la latence et améliorer les performances pour les équipes et les utilisateurs régionaux. Elle peut également aider les organisations à répondre aux exigences réglementaires liées à la résidence des données et à la confidentialité.
Moderniser l’infrastructure d’IA pour les environnements d’entreprise internationaux
La modernisation de l’infrastructure d’IA dans les organisations internationales passe souvent par des architectures hybrides combinant des centres de données sur site, des plateformes cloud et des ressources informatiques en périphérie. Cette approche permet d’exécuter les charges de travail là où les exigences de performances, de coûts et de réglementation peuvent être efficacement conciliées.
Les environnements hybrides offrent également une certaine flexibilité à mesure que les charges de travail d’IA évoluent. Les entreprises peuvent augmenter leur capacité de calcul grâce aux plateformes cloud tout en conservant le contrôle de leurs données sensibles et de leurs infrastructures critiques.
Liste de contrôle pour moderniser un centre de données d’IA
| Couche d’infrastructure | Ce qui doit changer pour l’IA |
|---|---|
| Calcul | Passer de systèmes centrés sur le CPU à des clusters de GPU accélérés prenant en charge l’entraînement, l’ajustement fin et l’inférence |
| Réseau | Prendre en charge un trafic est-ouest à large bande passante et faible latence entre les nœuds de calcul distribués |
| Refroidissement et alimentation | Prévoir une densité de racks plus élevée, un refroidissement liquide ou hybride et des besoins accrus en alimentation électrique |
| Stockage | Utiliser un stockage évolutif et hautes performances capable d’alimenter de grands jeux de données et de prendre en charge les pipelines d’IA |
| Données | Garantir que les grands jeux de données d’IA peuvent être stockés, traités et consultés efficacement sur l’ensemble des systèmes |
| Orchestration | Coordonner les charges de travail distribuées, le développement et le déploiement des modèles, la surveillance et la mise à l’échelle |
FAQ
Qu’est-ce qu’une usine d’IA et en quoi diffère-t-elle d’un centre de données traditionnel ?
Une usine d’IA est un environnement d’infrastructure conçu pour transformer les données d’entreprise en résultats d’IA à grande échelle. Un centre de données traditionnel est généralement optimisé pour les applications métier reposant sur des CPU, un trafic prévisible et un stockage polyvalent. Une usine d’IA est optimisée pour l’entraînement, l’ajustement fin et l’inférence des modèles d’IA, ainsi que pour les charges de travail agentiques, grâce à des capacités de calcul accélérées, des réseaux haut débit, un stockage évolutif, l’orchestration et des systèmes avancés d’alimentation électrique et de refroidissement.
Comment les entreprises modernisent-elles leurs centres de données pour les charges de travail d’IA ?
Les entreprises modernisent leurs centres de données en adoptant le calcul sur GPU, des réseaux haut débit, un stockage distribué et des plateformes d’orchestration pour les charges de travail de machine learning.
Qu’est-ce que l’architecture de l’infrastructure d’un centre de données d’IA ?
L’architecture de l’infrastructure d’un centre de données d’IA désigne les systèmes de calcul, de réseau, de stockage et les systèmes logiciels utilisés pour entraîner et déployer des modèles de machine learning. Dans les environnements modernes, cette architecture comprend généralement des clusters de GPU, des réseaux haut débit, des systèmes de stockage distribué et des plateformes d’orchestration prenant en charge l’entraînement et l’inférence de l’IA à grande échelle.
Pourquoi les charges de travail d’IA nécessitent-elles une infrastructure spécialisée ?
Les charges de travail d’IA nécessitent une infrastructure spécialisée, car elles traitent de grands jeux de données, reposent sur le calcul parallèle et exigent une communication rapide entre les systèmes.
Comment les organisations mettent-elles à l’échelle leurs environnements de calcul pour l’IA ?
Les organisations mettent à l’échelle leurs environnements d’IA en développant leurs clusters de GPU, en adoptant une infrastructure hybride et en utilisant des outils d’orchestration pour gérer les charges de travail distribuées.
Prêt à faire passer l’IA de l’expérimentation à l’impact à l’échelle de l’entreprise ? Découvrez le guide de TechRepublic intitulé Enterprise Guide to Scalable AI pour obtenir des conseils pratiques sur la stratégie, les données, l’infrastructure, les cas d’usage et le ROI.