








Ein Data Lakehouse ist eine hybride Datenmanagementarchitektur, die die besten Funktionen eines Data Lakes und eines Data Warehouses in einer einzigen Datenmanagementlösung vereint.
Ein Data Lake ist ein zentralisiertes Repository, das die Speicherung großer Datenmengen in ihrem nativen Rohformat ermöglicht. Ein Data Warehouse hingegen ist ein Repository, das strukturierte und semistrukturierte Daten aus mehreren Quellen für Analyse- und Reportingzwecke speichert.
Ein Data Lakehouse soll die Lücke zwischen diesen beiden Datenmanagementansätzen schließen, indem es die Flexibilität, Skalierbarkeit und geringen Kosten eines Data Lakes mit der Performance und den ACID-Transaktionen (Atomarität, Konsistenz, Isolation, Dauerhaftigkeit) von Data Warehouses verbindet. Dadurch werden Business Intelligence und Analysen aller Daten auf einer einzigen Plattform ermöglicht.
Direkt zu:
- Was macht ein Data Lakehouse?
- Unterschiede zwischen Data Lakehouse, Data Warehouse und Data Lake
- 5 Ebenen der Data-Lakehouse-Architektur
- Wichtige Funktionen eines Data Lakehouse
- Vorteile eines Data Lakehouse
- Herausforderungen eines Data Lakehouse
- Das Wichtigste zum Data Lakehouse
Was macht ein Data Lakehouse?
Ein Data Lakehouse nutzt die Skalierbarkeit, Flexibilität und Kosteneffizienz eines Daten-Repositorys und ermöglicht Unternehmen, große Datenmengen aufzunehmen, ohne strenge Anforderungen an Schema oder Format zu stellen.
Im Gegensatz zu Data Lakehouses fehlt es reinen Data Lakes an den Governance-, Organisations- und Performance-Funktionen, die für Analysen und Reporting erforderlich sind.
Data Lakehouses unterscheiden sich auch von Data Warehouses. Data Warehouses verwenden Extract, Load and Transform (ELT) oder alternativ Extract, Transform and Load (ETL), um strukturierte Daten in eine relationale Datenbankinfrastruktur zu laden – ein Data Warehouse unterstützt unternehmensweite Datenanalyse- und Business-Intelligence-Anwendungen. Ein Data Warehouse ist jedoch bei der Verarbeitung unstrukturierter und semistrukturierter Daten ineffizient. Außerdem können die Kosten steigen, wenn Datenquellen und Datenmenge im Laufe der Zeit zunehmen.
Data Lakehouses begegnen den Einschränkungen und Herausforderungen von Data Warehouses und Data Lakes, indem sie die Flexibilität und Kosteneffizienz von Data Lakes mit den Governance-, Organisations- und Performance-Funktionen von Data Warehouses verbinden.
Die folgenden Nutzergruppen können ein Data Lakehouse einsetzen:
- Data Scientists können ein Data Lakehouse für maschinelles Lernen, BI, SQL-Analysen und Data Science nutzen.
- Business Analysts können damit vielfältige Datenquellen und geschäftliche Anwendungsfälle untersuchen und analysieren.
- Produktmanager, Marketingfachleute, und Führungskräfte können Data Lakehouses nutzen, um wichtige Leistungskennzahlen und Trends zu überwachen.
Siehe auch: Was ist Datenanalyse?
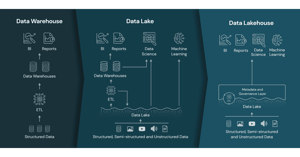
Das Data Lakehouse vereint die Funktionen eines Data Warehouses mit denen eines Data Lakes. Quelle: Databricks.
Vertiefung: Data Lakehouse vs. Data Warehouse und Data Lake
Wir haben festgestellt, dass ein Data Lakehouse aus den Funktionen von Data Warehouse und Data Lake hervorgegangen ist. Es ermöglicht eine effiziente und äußerst flexible Datenaufnahme. Sehen wir uns genauer an, wie sie sich vergleichen lassen.
Data Warehouse
Das Data Warehouse ist das „House“ im Data Lakehouse. Ein Data Warehouse ist eine Art Datenmanagementsystem, das speziell für Datenanalysen entwickelt wurde; es erleichtert und unterstützt Business-Intelligence-(BI-)Aktivitäten. Ein typisches Data Warehouse umfasst mehrere Elemente, darunter:
- Eine relationale Datenbank.
- Eine ELT-Lösung zur Vorbereitung der Daten für Analysen sowie Funktionen für statistische Analysen, Reporting und Data Mining.
- Ein Client-Analysetool für die Datenvisualisierung.
Data Lake
Ein Data Lake ist der „Lake“ in einem Data Lakehouse. Ein Data Lake ist ein flexibles, zentralisiertes Speicher-Repository, in dem sich strukturierte, semistrukturierte und unstrukturierte Daten in beliebigem Umfang speichern lassen. Ein Data Lake verwendet eine Schema-on-Read-Methodik. Das bedeutet, dass es kein vordefiniertes Schema gibt, in das Daten vor der Speicherung eingepasst werden müssen.
Diese Tabelle vergleicht die Konzepte Data Lakehouse, Data Warehouse und Data Lake.
| Parameter | Data Lakehouse | Data Warehouse | Data Lake |
|---|---|---|---|
| Datenstruktur | Strukturierte, semistrukturierte und Rohdaten | Strukturierte Daten (tabellarisch, relational) | Unstrukturierte, semistrukturierte und Rohdaten |
| Datenspeicherung | Verbindet strukturierte Daten und Rohdaten; Schema-on-Read | Speichert Daten in einem stark strukturierten Format mit einem vordefinierten Schema | Speichert Daten in ihrer Rohform (z. B. JSON, CSV), ohne ein verbindliches Schema |
| Schema | Verbindet Elemente von Schema-on-Read und Schema-on-Write | Verwendet ein festes Schema, bekannt als Star-, Galaxy- und Snowflake-Schema | Schema-on-Read, das heißt, Daten können ohne vordefiniertes Schema gespeichert werden |
| Abfrage-Performance | Verbindet die Stärken von Data Warehouse und Data Lake für eine ausgewogene Abfrage-Performance | Optimiert für schnelle Abfragen und Analysen durch Indexierungs- und Optimierungstechniken | Langsamere Abfrage-Performance |
| Datentransformation | Umfasst häufig Schema-Evolution und ETL-Funktionen | ETL und ELT | Begrenzte integrierte ETL-Funktionen; Daten müssen vor der Analyse häufig transformiert werden |
| Data Governance | Hängt von der jeweiligen Implementierung ab, ist aber im Allgemeinen besser als bei einem Data Lake | Starke Data Governance mit Kontrolle über Datenzugriff und Compliance | Begrenzte Data-Governance-Funktionen; Daten verfügen möglicherweise nicht über Governance-Funktionen |
| Anwendungsfälle | Analytische Workloads, die strukturierte Daten und Rohdaten verbinden | Business Intelligence, Reporting, strukturierte Analysen | Datenexploration, Datenaufnahme, Data Science |
| Tools und Ökosystem | Nutzt cloudbasierte Datenplattformen und Datenverarbeitungs-Frameworks | Verwendet typischerweise herkömmliche relationale Datenbanksysteme und ETL-Tools | Nutzt Big-Data-Technologien wie Hadoop, Spark und NoSQL-Datenbanken |
| Kosten | Kostengünstig | Teuer | Günstiger als ein Data Warehouse |
| Verbreitung | Wird für moderne Analyse-Workloads, die sowohl strukturierte als auch semistrukturierte Daten erfordern, zunehmend beliebter | In Unternehmen zur Analyse strukturierter Daten weit verbreitet | In Big-Data- und Data-Science-Szenarien weit verbreitet |
5 Ebenen der Data-Lakehouse-Architektur
Die IT-Architektur des Data Lakehouse besteht aus fünf Ebenen:
Aufnahmeebene
Die Datenaufnahme ist die erste Ebene der Data-Lakehouse-Architektur. Diese Ebene erfasst Daten aus verschiedenen Quellen und übermittelt sie an die Speicherebene oder das Datenverarbeitungssystem. Die Aufnahmeebene kann verschiedene Protokolle verwenden, um interne und externe Quellen anzubinden, darunter:
- Datenbankmanagementsysteme
- Software-as-a-Service-(SaaS-)Anwendungen
- NoSQL-Datenbanken
- Soziale Medien
- CRM-Anwendungen
- IoT-Sensoren
- Dateisysteme
Die Aufnahmeebene kann die Datenextraktion abhängig von Quelle und Datenmenge in einem einzigen großen Batch oder in kleinen Teilmengen durchführen.
Speicherebene
Die Speicherebene des Data Lakehouse nimmt alle Datentypen als Objekte in kostengünstigen Objektspeichern wie AWS S3 auf.
Diese Ebene speichert strukturierte, unstrukturierte und semistrukturierte Daten in Open-Source-Dateiformaten wie Parquet oder Optimized Row Columnar (ORC). Ein Data Lakehouse kann On-Premises mithilfe eines verteilten Dateisystems wie Hadoop Distributed File System (HDFS) oder über cloudbasierte Speicherdienste wie Amazon S3 implementiert werden.
Siehe auch: Die besten Datenanalyse-Softwarelösungen und -Tools
Metadatenebene
Diese Ebene ist sehr wichtig, da sie als Ursprung des Data Lakehouse dient. Metadaten sind Daten, die Informationen über andere Datenelemente liefern – auf dieser Ebene handelt es sich um einen einheitlichen Katalog mit Metadaten zu Data-Lake-Objekten. Die Metadatenebene bietet Nutzern außerdem eine Reihe von Verwaltungsfunktionen, darunter:
- ACID-Transaktionen (Atomarität, Konsistenz, Isolation, Dauerhaftigkeit) gewährleisten Atomarität, Konsistenz, Isolation und Dauerhaftigkeit bei Datenänderungen.
- Datei-Caching-Funktionen optimieren den Datenzugriff, indem häufig verwendete Dateien im Speicher unmittelbar verfügbar gehalten werden.
- Indexierung beschleunigt Abfragen, indem ein schneller Datenabruf ermöglicht wird.
- Datenversionierung ermöglicht es Nutzern, bestimmte Versionen der Daten zu speichern.
Die Metadatenebene ermöglicht es Nutzern, vordefinierte Schemata zu implementieren, um die Data Governance zu verbessern sowie Zugriffskontrolle und Auditierungsfunktionen zu ermöglichen.
API-Ebene
Die API-Ebene ist eine besonders wichtige Komponente eines Data Lakehouse. Sie ermöglicht es Dateningenieuren, Data Scientists und Analysten, auf die im Data Lakehouse gespeicherten Daten zuzugreifen und sie für Analysen, Berichte und andere Anwendungsfälle zu bearbeiten.
Konsumebene
Die Konsumebene ist die letzte Ebene der Data-Lakehouse-Architektur – sie wird zum Hosten von Tools und Anwendungen wie Power BI und Tableau verwendet und ermöglicht es Nutzern, die Daten abzufragen, zu analysieren und zu verarbeiten. Die Konsumebene ermöglicht es Nutzern, auf die im Data Lakehouse gespeicherten Daten für verschiedene geschäftliche Anwendungsfälle zuzugreifen und sie zu nutzen.
Wichtige Merkmale eines Data Lakehouse
- Unterstützung von ACID-Transaktionen: Viele Data Lakehouses verwenden eine Technologie wie Delta Lake (entwickelt von Databricks) oder implementieren ACID-Transaktionen, um Datenkonsistenz und -zuverlässigkeit in einer verteilten Umgebung zu gewährleisten.
- Einheitlicher, kostengünstiger Datenspeicher: Ein Data Lakehouse ist eine kostengünstige Option zur Speicherung aller Datentypen, einschließlich strukturierter, semistrukturierter und unstrukturierter Daten.
- Unterstützung unstrukturierter Daten und von Streaming-Daten: Während ein Data Warehouse auf strukturierte Daten beschränkt ist, unterstützt ein Data Lakehouse zahlreiche Datenformate, darunter Videos, Audiodateien, Textdokumente, PDF-Dateien, Systemprotokolle und vieles mehr. Ein Data Lakehouse unterstützt außerdem die Echtzeitaufnahme von Daten sowie das Streaming von Geräten.
- Unterstützung offener Formate: Data Lakehouses können Daten in standardisierten Dateiformaten wie Apache Avro, Parquet und ORC (Optimized Row Columnar) speichern.
Vorteile eines Data Lakehouse
Ein Data Lakehouse bietet zahlreiche Vorteile und ist damit eine überzeugende Alternative zu einem eigenständigen Data Warehouse oder Data Lake. Data Lakehouses verbinden die hohe Servicequalität und Leistungsfähigkeit eines Data Warehouse mit der Kosteneffizienz und flexiblen Speicherinfrastruktur eines Data Lake. Ein Data Lakehouse hilft Datennutzern, die folgenden Probleme zu lösen.
- Vereinheitlichte Datenplattform: Sie dient als Repository für strukturierte und unstrukturierte Daten und beseitigt Datensilos.
- Echtzeit- und Stapelverarbeitung: Data Lakehouses unterstützen die Echtzeitverarbeitung für schnelle und unmittelbare Erkenntnisse sowie die Stapelverarbeitung für Analysen und Berichte im großen Maßstab.
- Geringere Kosten: Die Pflege eines separaten Data Warehouse und Data Lake kann zu teuer sein. Mit einem Data Lakehouse müssen Datenmanagementteams nur eine Datenplattform bereitstellen und verwalten.
- Bessere Data Governance: Data Lakehouses konsolidieren Ressourcen und Datenquellen und ermöglichen dadurch eine bessere Kontrolle über Sicherheit, Metriken, rollenbasierten Zugriff und andere wichtige Verwaltungselemente.
- Weniger Datenduplizierung: Wenn Kopien derselben Daten in unterschiedlichen Systemen existieren, sind sie mit größerer Wahrscheinlichkeit inkonsistent und weniger vertrauenswürdig. Data Lakehouses stellen Unternehmen eine zentrale Datenquelle bereit, die im gesamten Unternehmen gemeinsam genutzt werden kann. Dadurch werden Inkonsistenzen und zusätzliche Speicherkosten durch Datenduplizierung verhindert.
Herausforderungen eines Data Lakehouse
Ein Data Lakehouse ist kein Allheilmittel für alle datenbezogenen Herausforderungen. Das Konzept des Data Lakehouse ist relativ neu, und sein volles Potenzial sowie seine Fähigkeiten werden noch erforscht und verstanden.
Ein Data Lakehouse ist ein komplexes System, das von Grund auf aufgebaut werden muss. Sie müssen sich entweder für eine sofort einsatzbereite Data-Lakehouse-Lösung entscheiden, deren Leistung je nach Abfragetyp und verarbeitender Engine stark variiert, oder Zeit und Ressourcen in die Entwicklung und Wartung einer eigenen Lösung investieren.
Fazit: das Data Lakehouse
Das Data Lakehouse ist ein neues Konzept, das einen modernen Ansatz für das Datenmanagement darstellt. Es ist kein vollständiger Ersatz für das herkömmliche Data Warehouse oder den Data Lake, sondern eine Kombination aus beiden.
Obwohl Data Lakehouses viele Vorteile bieten und dadurch attraktiv sind, sind sie nicht unfehlbar. Sie müssen proaktiv Maßnahmen ergreifen, um Sicherheitsrisiken, Komplexität sowie mögliche Probleme mit Datenqualität und Data Governance bei der Nutzung eines Data-Lakehouse-Systems zu vermeiden und zu bewältigen.
Siehe auch: Best Practices für generative KI und Datenanalyse