








Jedes Mal, wenn ChatGPT in drei statt in 30 Sekunden antwortet, steckt dahinter wahrscheinlich Infrastruktur wie vLLM.
Du hast sie bereits genutzt, ohne es zu wissen. Und jetzt ist das Team dahinter über Nacht zu einem 800-Millionen-US-Dollar-Unternehmen geworden.
Hier sind die Details
Heute hat Inferact mit einer gewaltigen Seed-Runde über 150 Millionen US-Dollar den Betrieb der Open-Source-Inferenz-Engine aufgenommen, die bereits KI bei Amazon, großen Cloud-Anbietern und Tausenden Entwicklern weltweit antreibt. Andreessen Horowitz und Lightspeed führten die Runde an, an der sich auch Sequoia, Databricks und andere beteiligten.
Was ist vLLM eigentlich? Stell es dir als den Unterschied zwischen einem Stau und einem KI-Autobahnsystem vor. Wenn du ChatGPT eine Frage stellst, durchläuft deine Anfrage einen „Inferenz“-Prozess – das Modell generiert deine Antwort Wort für Wort. vLLM macht diesen Prozess durch zwei zentrale Innovationen drastisch schneller und günstiger:
PagedAttention: Verwaltet den Speicher ähnlich wie dein Computer den Arbeitsspeicher und reduziert dadurch die Verschwendung im Vergleich zu herkömmlichen Methoden um bis zu 24-mal.
Continuous Batching: Statt Anfragen nacheinander zu verarbeiten, bearbeitet vLLM mehrere Anfragen gleichzeitig – wie ein Restaurant, das zehn Tische auf einmal bedient, anstatt mit der Platzierung des nächsten Gastes zu warten, bis der vorherige fertig ist.
Unternehmen, die vLLM einsetzen, berichten von Inferenzgeschwindigkeiten, die 2- bis 24-mal schneller sind als bei Standardimplementierungen – bei drastisch niedrigeren Kosten. Seit dem Start 2023 im Sky Computing Lab der UC Berkeley hat das Projekt mehr als 2.000 Code-Beitragende angezogen.
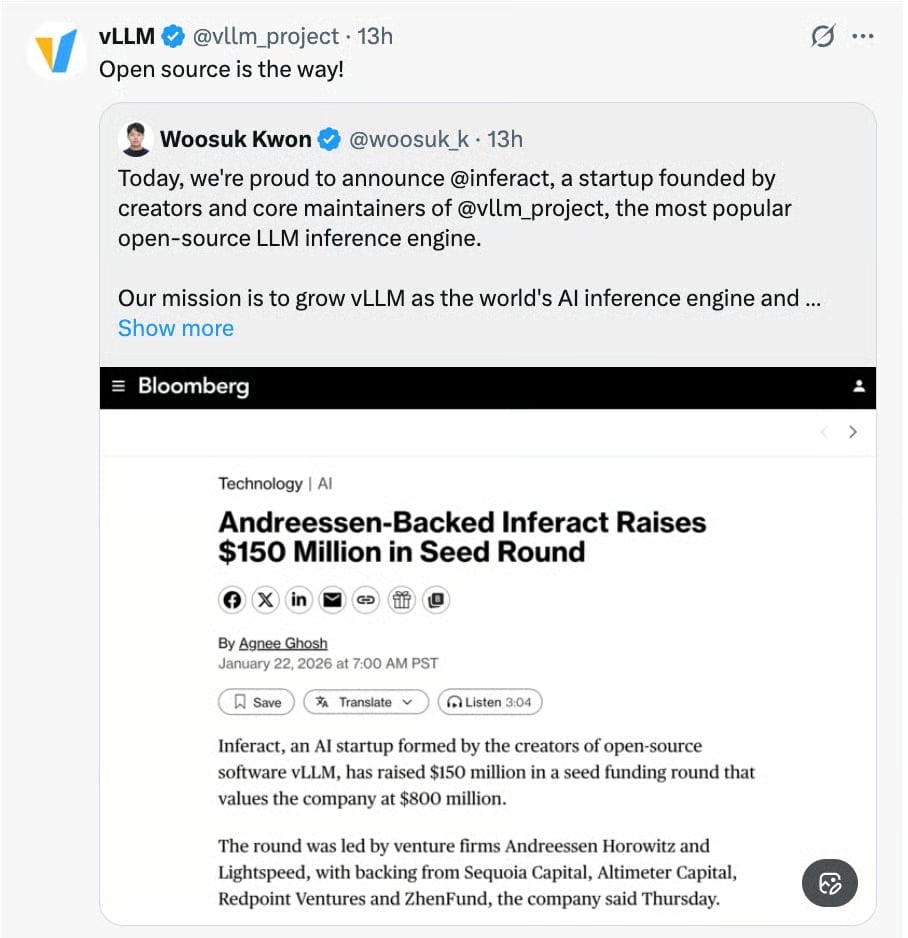
Bild: X
Warum das wichtig ist
Bei KI verlagert sich das Problem vom Training zur Bereitstellung.
Ein intelligentes Modell zu entwickeln, ist nicht länger der Engpass (alle wichtigsten Modelle sind gut), sondern es erschwinglich in großem Maßstab zu betreiben. Wenn Unternehmen dieses Jahr vom Experimentieren mit ChatGPT zum Einsatz von KI für Millionen von Nutzern übergehen, wird die Optimierung der Inferenz den Unterschied zwischen Gewinn und Insolvenz ausmachen.
Erwarte, dass sich jedes große KI-Unternehmen im Jahr 2026 obsessiv mit der Wirtschaftlichkeit von Inferenz beschäftigt. Die Gewinner werden nicht unbedingt die intelligentesten Modelle sein, sondern diejenigen, die Vorhersagen schnell genug und günstig genug bereitstellen können, um tatsächlich Geld zu verdienen.
Für Sie: Wenn Ihr Unternehmen KI-Tools bewertet, fragen Sie die Anbieter nach ihrer Inferenzinfrastruktur. Tools, die auf Engines wie vLLM basieren, lassen sich kosteneffizienter skalieren als proprietäre Lösungen, die dieses Problem noch nicht gelöst haben. Der Open-Source-Vorteil ist hier real … und jetzt auch von Risikokapital finanziert.
Anmerkung der Redaktion: Dieser Inhalt erschien ursprünglich im Newsletter unserer Schwesterpublikation The Neuron. Um mehr von The Neuron zu lesen, melden Sie sich hier für den Newsletter an.