








Chaque fois que ChatGPT met trois secondes à répondre au lieu de 30, il y a probablement une infrastructure comme vLLM qui travaille en coulisses.
Vous l’utilisez sans le savoir. Et maintenant, l’équipe qui l’a conçu vient de devenir du jour au lendemain une entreprise valorisée à 800 millions de dollars US.
Voici les détails
Aujourd’hui, Inferact a été lancée avec une levée de fonds d’amorçage colossale de 150 millions de dollars US pour commercialiser le moteur d’inférence open source qui alimente déjà l’IA chez Amazon, les principaux fournisseurs de cloud et des milliers de développeurs dans le monde. Andreessen Horowitz et Lightspeed ont dirigé cette levée, avec la participation de Sequoia, Databricks et d’autres investisseurs.
Qu’est-ce que vLLM, au juste ? Imaginez la différence entre un embouteillage et un réseau autoroutier pour l’IA. Lorsque vous posez une question à ChatGPT, votre requête passe par un processus d’« inférence » : le modèle génère votre réponse, mot après mot. vLLM rend ce processus beaucoup plus rapide et moins coûteux grâce à deux innovations clés :
PagedAttention : gère la mémoire comme votre ordinateur gère sa RAM, en réduisant le gaspillage jusqu’à 24 fois par rapport aux méthodes traditionnelles.
Traitement par lots continu : au lieu de traiter une requête à la fois, vLLM en gère plusieurs simultanément, comme un restaurant qui sert 10 tables en même temps au lieu d’attendre que chaque client ait terminé avant d’installer le suivant.
Les entreprises qui utilisent vLLM font état de vitesses d’inférence 2 à 24 fois supérieures à celles des implémentations standard, pour des coûts considérablement réduits. Le projet a attiré plus de 2 000 contributeurs au code depuis son lancement en 2023 au Sky Computing Lab de l’UC Berkeley.
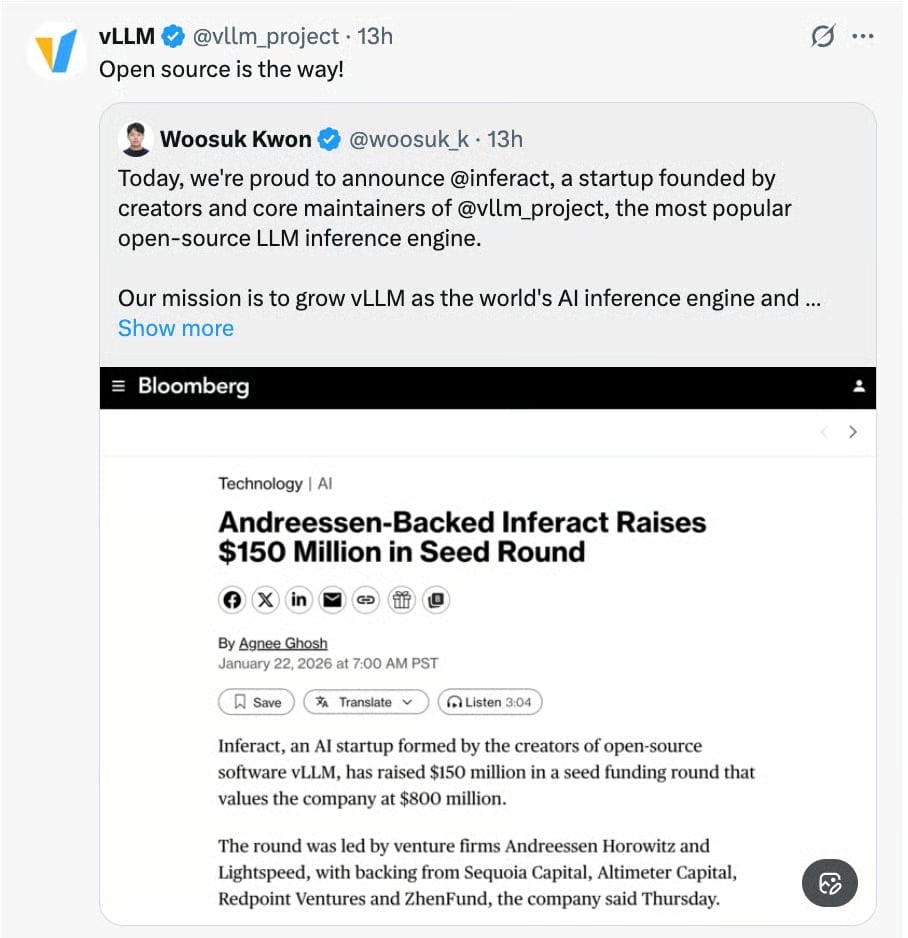
Image : X
Pourquoi c’est important
L’IA passe d’un problème d’entraînement à un problème de déploiement.
Construire un modèle intelligent n’est plus le goulot d’étranglement (tous les modèles principaux sont bons), c’est son exécution à grande échelle à un coût abordable qui pose problème. Alors que les entreprises passent cette année de l’expérimentation avec ChatGPT au déploiement de l’IA auprès de millions d’utilisateurs, l’optimisation de l’inférence devient la différence entre les bénéfices et la faillite.
Attendez-vous à ce que toutes les grandes entreprises d’IA se passionnent pour l’économie de l’inférence en 2026. Les gagnants ne seront pas nécessairement les modèles les plus intelligents, mais ceux capables de fournir des prédictions assez rapidement et à moindre coût pour réellement gagner de l’argent.
Pour vous: Si votre entreprise évalue des outils d’IA, interrogez les fournisseurs sur leur infrastructure d’inférence. Les outils construits sur des moteurs comme vLLM passeront à l’échelle de manière plus économique que les solutions propriétaires qui n’ont pas résolu ce problème. L’avantage de l’open source est bien réel ici… et il est désormais financé par le capital-risque.
Note de la rédaction : ce contenu a été publié à l’origine dans la newsletter de notre publication sœur, The Neuron. Pour lire d’autres articles de The Neuron, inscrivez-vous à sa newsletter ici.