






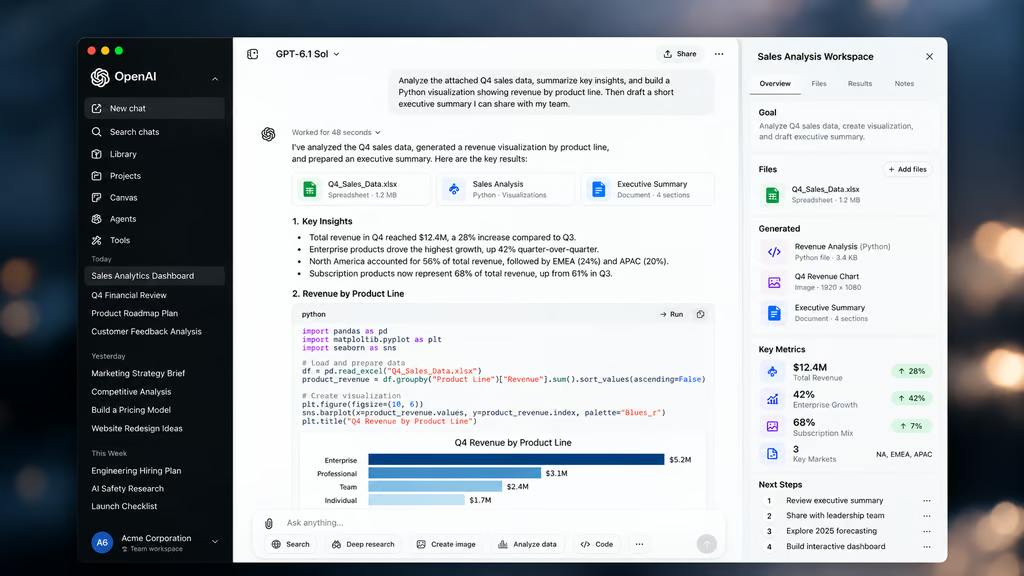
GPT-6 Sol hatte kaum Zeit, sich zu etablieren, bevor sein Nachfolger erschien.
OpenAI veröffentlichte GPT-6.1 Sol am 29. September, sieben Tage nach GPT-6 Sol. Die Tests des Unternehmens zeigen Fortschritte bei der Programmierung, der Computernutzung und der professionellen Arbeit; mehrere Ergebnisse nähern sich GPT-6 Astra an.
Die Leistung erklärt einen Teil der schnellen Nachfolgeversion. Separate Sicherheitstests ordnen das neuere Modell außerdem einer anderen Kategorie der Cybersicherheit zu, sodass Unternehmen mehr prüfen müssen als nur Benchmark-Gewinne.
Programmierung und Computernutzung führen die Leistungszuwächse an
GPT-6.1 Sol schlägt Astra bei DeepSWE v1.1, einer Bewertung für Softwareentwicklung mit echten Codebasen, und übertrifft das beste Ergebnis von GPT-6 Sol um 6,4 Prozentpunkte. Bei der Offline-Bewertung der Computernutzung OSWorld 2.0 erzielte das Modell bei maximalem Denkaufwand sieben Prozentpunkte mehr als sein Vorgänger. Entwicklungsteams dürften diese Fortschritte vor allem bei Programmieraufgaben und Softwareaufgaben bemerken, die mehrere Schritte statt einer einzigen Eingabe umfassen.
Auch die professionelle Arbeit wurde verbessert. Bei AutomationBench, das mehrstufige Geschäftsabläufe testet, meldete OpenAI bei mittlerem Denkaufwand einen Zuwachs von 4,8 Prozentpunkten gegenüber GPT-6 Sol. Bei GDP.pdf, das Antworten auf fachliche Fragen anhand komplexer PDFs prüft, näherte sich das neue Modell der Leistung von GPT-6 Astra an. Beschäftigte, die KI nutzen, um Geschäftsanwendungen oder Dokumente mit Tabellen und Diagrammen zu bearbeiten, sind damit näher an den Aufgaben, die diese Bewertungen messen.
Teams, die GPT-6.1 Sol für Unternehmens-KI in Betracht ziehen, sollten die für sie wichtigen Programmier- und Dokumentenabläufe erneut ausführen, bevor sie eine bestehende Bereitstellung ersetzen. Proprietäre Daten und unternehmensspezifische Software können andere Ergebnisse liefern als kontrollierte Tests.
Work und Codex erhalten zuerst Zugriff
GPT-6.1 Sol wird über ChatGPT Work und Codex eingeführt, zunächst für Pro-Nutzer und anschließend für Plus, Business, Enterprise und Edu. Entwickler können ebenfalls über die API darauf zugreifen. Normale ChatGPT-Unterhaltungen enthalten GPT-6.1 Sol zum Start nicht, daher konzentrieren sich die ersten Nutzer auf Arbeits- und Entwicklungsumgebungen.
ChatGPT Work bearbeitet mehrstufige Aufgaben über Dateien und verbundene Software hinweg. Codex konzentriert sich auf die Softwareentwicklung. Beide können 6.1 in Umgebungen einsetzen, in denen KI-Agenten Unternehmensinformationen lesen oder genehmigte Aktionen ausführen, wodurch Zugriffskontrollen von Anfang an Teil der Bereitstellung sind.
Administratoren von Enterprise und Edu entscheiden, wer das neue Sol-Modell nutzen darf. Mit den Administrationskontrollen können IT-Teams repräsentative Arbeitslasten testen, den Zugriff der einzelnen Gruppen beschränken und die Verfügbarkeit erweitern, nachdem diese Einstellungen geprüft wurden.
Was eWeek herausfand: Die Erfolgsquote von GPT-6.1 Sol bei Exploits stieg fast auf das Vierfache
eWeek verglich die veröffentlichten Cybersicherheitsergebnisse von OpenAI für GPT-6 Sol und GPT-6.1 Sol. Bei ExploitBench erreichte GPT-6.1 Sol eine Erfolgsquote von 21,5 %, gegenüber 5,5 % bei GPT-6 Sol. Die Berechnung ergibt für das neuere Modell bei diesem Test eine etwa 3,9-mal so hohe Quote wie für seinen Vorgänger.
OpenAIs Sicherheitsbewertung verzeichnete außerdem höhere Werte bei zwei weiteren Cybertests und stufte GPT-6.1 Sol als „Critical“ ein, nachdem GPT-6 Sol bei „High“ geblieben war.
Bewertung | GPT-6 Sol | GPT-6.1 Sol | Änderung |
| ExploitBench | 5.5% | 21.5% | +16 Punkte, etwa 3,9-fach |
| SEC-Bench Pro | 66.3% | 78.8% | +12,5 Punkte |
| ExploitGym | 22.1% | 35.1% | +13 Punkte |
| OpenAI-Cybereinstufung | High | Critical | Schwelle für Critical überschritten |
Die Vergleiche von Prozentpunkten und 3,9-fach wurden von eWeek anhand der veröffentlichten Ergebnisse von OpenAI berechnet.
ExploitBench testet einen schwierigen Teil der Schwachstellenforschung. Eine Schwachstelle wurde veröffentlicht, doch das Modell muss noch herausfinden, wie daraus funktionsfähiger Exploit-Code erstellt werden kann. Eine bessere Leistung könnte es Sicherheitsteams ermöglichen, neu offengelegte Fehler schneller nachzustellen, zu überprüfen, ob ihre eigenen Systeme gefährdet sind, und zu testen, ob ein Patch die Ausnutzung tatsächlich verhindert.
Cyberfähigkeiten wirken in beide Richtungen. Öffentlich zugängliche Informationen über Schwachstellen können auch von Angreifern genutzt werden, die funktionsfähige Exploits erstellen wollen. Ein Modell, das diesen Schritt häufiger erfolgreich bewältigt, könnte einen Teil der technischen Arbeit zwischen der Offenlegung eines Fehlers und einem versuchten Angriff verkürzen. Der Benchmark von OpenAI zeigt nicht, wie oft GPT-6.1 Sol gegen reale Unternehmenssysteme erfolgreich wäre. Die Zahl von 21,5 % sollte daher nicht als Kompromittierungsrate in der realen Welt verstanden werden.
Das Überschreiten der Critical-Schwelle stellt Sicherheitsverantwortliche vor eine andere Frage. GPT-6.1 Sol ist nicht nur ein besseres allgemeines Arbeitsmodell. Die veröffentlichten Ergebnisse deuten darauf hin, dass es Cybersicherheitsaufgaben ausführen kann, für die zuvor spezialisierteres menschliches Fachwissen erforderlich war. Unternehmen, die das Modell für Sicherheitsforschung bewerten, können prüfen, an welchen Stellen diese Fähigkeit Schwachstellentests beschleunigt, und anschließend entscheiden, welche risikoreicheren Aktionen weiterhin von einer Person überprüft werden müssen, bevor sie die Arbeit des KI-Modells’s prüfen.
Möchten Sie mehr über KI-Tipps, Tricks und Prompting-Techniken erfahren? eWeek-Leser erhalten 7 Tage kostenlosen Zugang zur The Neuron Academy, unserer praxisorientierten Lernplattform, die Fachleuten helfen soll, KI sicherer bei der Arbeit einzusetzen. Alle Lektionen ansehen →
Lassen Sie sich kostenlos beibringen, wie man mit KI spricht! Probieren Sie unseren sechminütigen Kurs bei The Neuron Academy aus und lernen Sie einige einfache Möglichkeiten kennen, bessere Prompts zu schreiben und nützlichere Ergebnisse von KI zu erhalten, oder stöbern Sie sieben Tage lang kostenlos durch unseren anderen KI-Kurs. Alle Lektionen hier ansehen →