






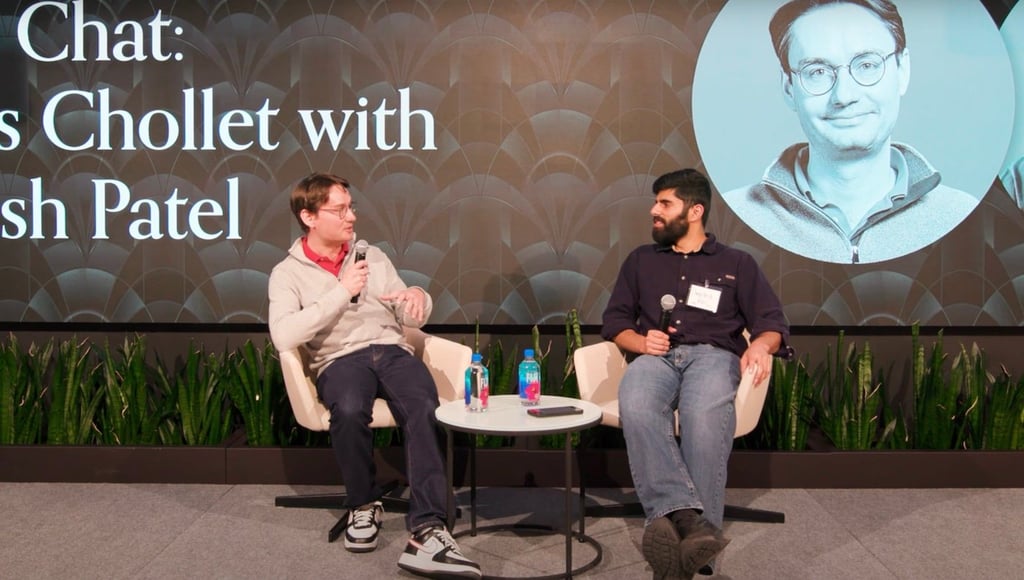


Der Schöpfer von Keras und einer der einflussreichsten Denker im Bereich KI, François Chollet, hat gerade seinen Zeitplan für AGI verkürzt – von 10 auf fünf Jahre. Doch der Grund dafür ist wirklich interessant … und es geht nicht darum, größere Modelle zu skalieren.
In einem neuen Gespräch mit Dwarkesh Patel erklärte Chollet, sein Optimismus beruhe auf einem grundlegenden Wandel der KI-Fähigkeiten. Jahrelang argumentierte er, Modelle steckten in einer „statischen“ Schleife fest und würden lediglich Vorlagen auswendig lernen und erneut anwenden.
Nun, so sagt er, haben wir endlich KIs, die echte „fluide Intelligenz“ zeigen, indem sie sich beim Testen an neuartige Probleme anpassen – ein entscheidender Schritt hin zu echtem Schlussfolgern. Hier kommt sein neuer Benchmark-Test ins Spiel.
Neuer ARC-AGI-3-Benchmark
ARC-AGI-3 ist ein „interaktiver Reasoning-Benchmark“, der einfache Videospiele nutzt, um die Fähigkeit einer KI zu messen, spontan zu lernen. Ziel ist es, die „Effizienz des Fähigkeitserwerbs“ zu testen – also wie schnell eine KI in einer völlig neuen Umgebung Dinge herausfinden kann, ganz wie ein Mensch.
Was ARC-AGI-3 anders macht
Der Benchmark ist so konzipiert, dass er für Menschen einfach ist (man sollte ihn in weniger als einer Minute verstehen können – probieren Sie ihn hier selbst aus), für aktuelle KI-Systeme aber unglaublich schwierig.
Statt statischer Aufgaben müssen KIs etwa 100 einzigartige Spielwelten erkunden, planen und darin handeln. Die KI wird ohne jegliche Anleitung in ein Spiel versetzt und muss Regeln und Ziele durch Versuch und Irrtum vollständig selbst herausfinden.
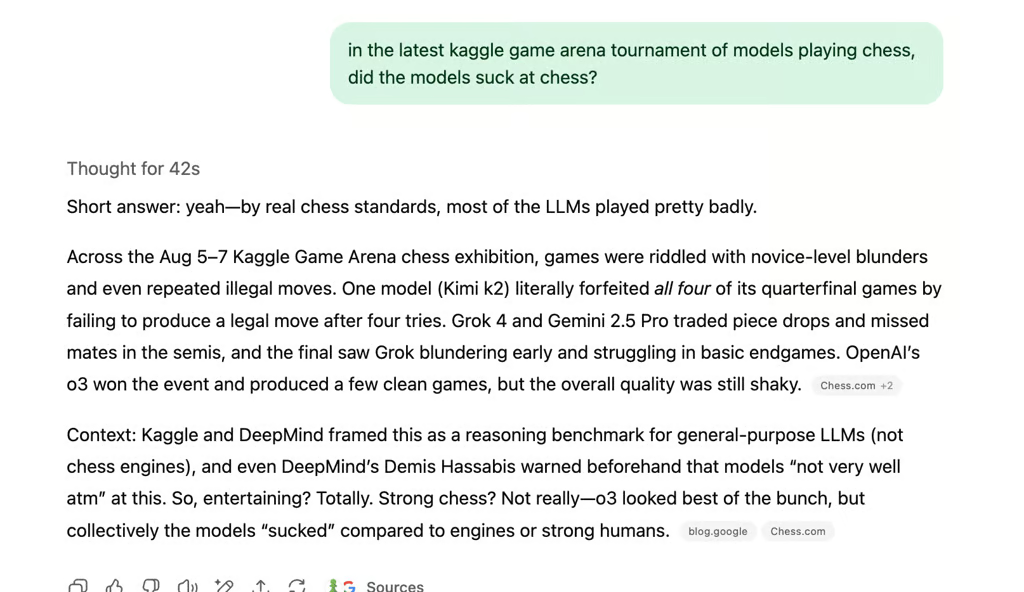
Das erinnert uns an Googles DeepMind Kaggle Game Arena, wo man KI-Modelle bei direkten Duellen in Spielen wie Schach und Go beobachten kann. Hier ist das aktuelle Schach-Tableau, Sie können hier alle Partien ansehen und die Zusammenfassung des Finales durch den Schachweltmeister Magnus Carlsen lesen. Aus Magnus’ Kommentaren hatten wir den Eindruck, dass die KI irgendwie ziemlich schlecht war, also baten wir GPT-5 um eine Bestätigung.
Warum spielt es eine Rolle, ob KIs gut in Spielen sind? Wie Chollet sagt: „Solange wir uns Probleme ausdenken können, die Menschen lösen können, eine KI aber nicht, haben wir keine AGI.“
Wie schließen wir die Lücke?
Chollets Antwort zielt auf das größte Problem der heutigen KI – eines, das von seinem Gastgeber Dwarkesh Patel berühmt beschrieben wurde: Die heutigen Modelle sind wie ein „dauerhafter Praktikant am ersten Tag“. Sie sind von Anfang an brillant, lernen aber nie aus Erfahrung.
Chollets vorgeschlagene Lösung dafür ist im Grunde ein „GitHub für Intelligenz“. Statt lediglich Aufgaben auszuführen, würde seine theoretische AGI eine dreistufige Schleife durchlaufen, um echtes, sich verstärkendes Lernen zu erreichen:
- Eine neue Fähigkeit erlernen: Ein KI-Agent findet effizient heraus, wie sich eine neuartige Aufgabe lösen lässt.
- Die Lösung zerlegen: Anschließend zerlegt er diese Lösung in ihre wesentlichen, wiederverwendbaren Bestandteile.
- Mit dem Netzwerk teilen: Er lädt diese neuen wiederverwendbaren Bestandteile in eine globale Bibliothek hoch, wodurch sie sofort Millionen anderer KI-Agenten zur Verfügung stehen.
Der entscheidende Wendepunkt
Der entscheidende Wendepunkt ist also nicht die reine Intelligenz, sondern das kollektive Lernen. Chollet stellt sich ein System vor, in dem jede von einem Agenten erlernte Fähigkeit zu einem dauerhaften, sofort zugänglichen Baustein für alle anderen wird. Während Menschen isoliert lernen, würde diese AGI als Kollektiv lernen und ihr Wissen in unglaublichem Tempo mehren. Was laut Dwarkesh im Grunde die Singularität wäre (also der Punkt, an dem KI den Menschen übertrifft).
Mehr zu diesem Thema erfahren Sie in meinem ausführlichen Beitrag zu Chollets Änderung des AGI-Zeitplans und dem neuen Benchmark.
Anmerkung der Redaktion: Dieser Inhalt erschien ursprünglich in der heutigen Ausgabe des Newsletters unserer Schwesterpublikation The Neuron. Weitere Beiträge von The Neuron können Sie lesen, wenn Sie sich hier für den Newsletter anmelden.