






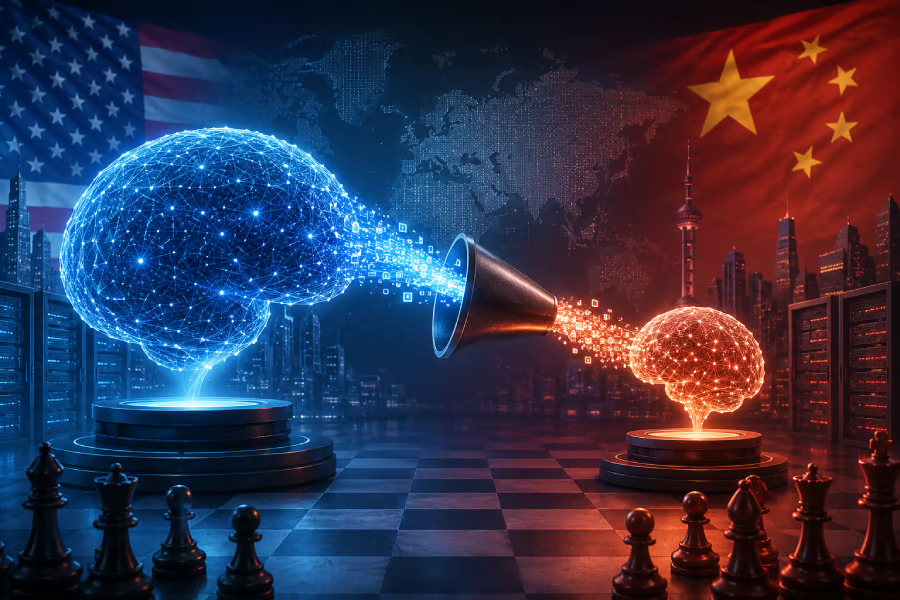


KI-Unternehmen beschuldigen ihre Konkurrenten, ihre Hausaufgaben abzuschreiben – Millionen Antworten auf einmal.
Im Zentrum des Streits steht die Modelldestillation, eine standardmäßige Trainingstechnik, bei der ein großes, teures KI-System dabei hilft, ein kleineres und günstigeres zu trainieren. Die Methode ermöglicht effiziente Modelle, die in Smartphones, privaten Netzwerken und Unternehmenssoftware zum Einsatz kommen. Vorwürfe, Unternehmen würden Fähigkeiten aus geschlossenen US-Systemen extrahieren, haben sie jedoch in einen geopolitischen Streit und einen Konflikt um geistiges Eigentum verwandelt.
Die schwierige Frage ist nicht, ob es Destillation geben sollte. Es geht darum, wo legitimes Lernen endet und unbefugtes Kopieren beginnt.
Die Idee ist nicht neu. Googles Chief Scientist Jeff Dean sagte in einem Podcast im Februar , dass sein Team vor Jahren zufällig auf die Destillation stieß, als es versuchte, die Leistung zu steigern, ohne sich auf ein einziges riesiges Bilderkennungsmodell zu verlassen.
Destillation überschneidet sich mit dem Training anhand synthetischer Daten und der Modellextraktion, doch die Begriffe sind nicht austauschbar. Bei der traditionellen Destillation wird das Verhalten eines Lehrermodells meist gezielt auf ein Schülermodell übertragen, während sich Extraktion häufig auf die Reproduktion der Fähigkeiten eines Systems durch wiederholte Abfragen ohne Mitwirkung des Eigentümers bezieht.
Warum Unternehmen KI-Modelle destillieren
Frontier-Modelle können enorme Investitionen in Chips, Rechenzentren, Energie und Entwicklung erfordern. Destillation bietet einen günstigeren Weg: Unternehmen können einen Teil der Fähigkeiten eines größeren Modells in ein System übertragen, das für eine engere Aufgabe konzipiert ist.
Dieser Kompromiss erklärt, warum destillierte Modelle in Smartphones, Fabrikanlagen, Autos und privaten Unternehmensnetzwerken auftauchen – an Orten, an denen ein klobiges Frontier-Modell niemals Platz hätte.
2019 stellte Hugging Face DistilBERT vor, eine der bekanntesten destillierten Versionen von Googles Sprachmodell BERT. Die Zahl der Parameter wurde um beinahe die Hälfte reduziert, das Modell lief etwa 60 % schneller und behielt bei Standard-Benchmarks rund 97 % der Leistung von BERT bei.
Warum Schlussfolgerungen wichtig sind
Bei älteren Destillationsverfahren wurden hauptsächlich die endgültigen Antworten kopiert. Neuere Systeme können auch ausführliche Schlussfolgerungen ausgeben: schriftliche Zwischenschritte, die zeigen, wie sie offenbar ein Problem bearbeiten. Diese Ausgaben bieten nicht zwangsläufig einen zuverlässigen Einblick in die interne Berechnung eines Modells, können aber weitaus umfangreicheres Trainingsmaterial liefern als eine bloße Endantwort.
Florian Tramèr, Assistenzprofessor an der ETH Zürich und Forscher zur Sicherheit maschinellen Lernens, verglich dies mit dem Lösen von Mathehausaufgaben. Aus einem Buch zu lernen, das nur die Endergebnisse zeigt, ist wesentlich schwieriger als aus einem, das jeden Schritt erklärt, sagte er. Weil Schlussfolgerungsspuren mehr darüber verraten, wie ein Modell funktioniert, betrachten Unternehmen den Zugang dazu inzwischen als sensibler als den Zugang zu schlichten Ausgaben.
Wo die Grenze überschritten wird
Destillation an sich ist weder illegal noch ungewöhnlich. Stanford setzte bei seinem Alpaca-Projekt und Microsoft bei seiner Orca-Forschung Ausgaben größerer Modelle ein, um kleinere Modelle zu trainieren, und chinesische Forscher haben ähnliche Arbeiten zur Entwicklung chinesischsprachiger Instruktionsmodelle veröffentlicht. Beim Streit geht es um die Erlaubnis und den Umfang, nicht um die Technik.
Open-Weight-Modelle stellen ihre Parameter zur Untersuchung oder Veränderung bereit, doch die damit verbundenen Rechte hängen von der Lizenz ab. Sie geben Entwicklern im Allgemeinen mehr Spielraum, ein System zu untersuchen und anzupassen, als geschlossene Modelle, wobei weiterhin Einschränkungen für die kommerzielle Nutzung und Weiterverbreitung gelten können.
Anthropic hat chinesische Unternehmen beschuldigt DeepSeek, Moonshot AI und MiniMax, groß angelegte Kampagnen zu betreiben, um Fähigkeiten aus Claude herauszuziehen. Berichten zufolge nutzten sie etwa 24.000 gefälschte Konten, um 16 Millionen Interaktionen zu erzeugen, die auf Softwareentwicklung und Schlussfolgerungsfähigkeiten abzielten.
Der Streit eskalierte weiter, nachdem Moonshot sein Modell Kimi K3 veröffentlicht hatte, das in Tests mit führenden US-Systemen konkurrieren konnte. Der Direktor des White House Office of Science and Technology Policy (OSTP), Michael Kratsios, behauptete auf X , Moonshot habe „Anthropics Fable für die Entwicklung seines K3-Modells destilliert“, und dabei „eine hochentwickelte interne Plattform eingesetzt, um groß angelegte Destillationen gegen US-Modelle durchzuführen“, die der Entdeckung entgehen sollte.
Moonshot hat die Behauptung zurückgewiesen.
OpenAI erklärte, es habe ebenfalls chinesische Versuche zur Destillation seiner Modelle entdeckt.
US-Techunternehmen sind gespalten
Mehr als 60 Unternehmen – darunter Nvidia, Microsoft, Meta und Palantir – unterzeichneten einen Brief, in dem sie politische Entscheidungsträger vor „verfrühten Einschränkungen“ für Open-Weight-KI warnten, die „den Wettbewerb ersticken oder Innovationen ins Ausland treiben“ würden. Zur Destillation schrieb die Gruppe, sie sei „eine weit verbreitete Technik zur Verbesserung, Bewertung und Validierung von Modellen“. Nvidia setzte die Methode ein, um seine eigenen Llama-Nemotron-Modelle zu trainieren.
Bemerkenswerterweise unterzeichnete Anthropic diesen Brief nicht. Eines der Unternehmen, das durch die unbefugte Destillation seiner eigenen Systeme am meisten zu verlieren hätte, hielt sich heraus, während Firmen, die Chips, Cloud-Infrastruktur und Open-Weight-Tools verkaufen, lockerere Regeln unterstützten.
Pukar Hamal, Gründer des KI-Sicherheitsunternehmens SecurityPal, beschrieb unbefugte Destillation unverblümt: „Es ist fast so, als wäre jemand zu den Vorlesungen gegangen, hätte das Lehrbuch gelesen und die ganze harte Arbeit bei den Hausaufgaben erledigt. Und dann kommt ein anderer Schüler und sagt: ‚Hey, ich habe das nicht gemacht. Kann ich einfach deine Arbeit kopieren?‘“
Hamal sagte jedoch auch, dass er ein chinesisches Open-Weight-Modell wie Kimi K3 in seinem eigenen Unternehmen einsetzen würde, wenn es Geld sparen würde – vorausgesetzt, es würde auf Hintertüren geprüft und auf seiner eigenen Infrastruktur betrieben, wie CNBC berichtet.
Worauf Unternehmen achten sollten
Unternehmen, die KI einsetzen, haben auch jenseits der Geopolitik ganz praktische Gründe, sich dafür zu interessieren. Wenn ein Unternehmen ein Modell mit seinen eigenen proprietären Daten feinjustiert, ist diese feinjustierte Version ein Unternehmenswert, der seinerseits ohne Erlaubnis von Außenstehenden destilliert werden kann. Zu den grundlegenden Schutzmaßnahmen gehören die Begrenzung der API-Abfragerate, die Protokollierung von Anfragen auf Muster, die auf systematische Extraktion hindeuten, Anti-Destillationsklauseln in die Nutzungsbedingungen aufzunehmen und die sensibelsten Modelle vollständig von öffentlich zugänglichen Endpunkten fernzuhalten.
Käufer, die ein beliebiges Modell – ob amerikanisch oder chinesisch, geschlossen oder als Open-Weight-Modell – prüfen, sollten ebenfalls fragen, woher dessen Trainingsdaten tatsächlich stammen, da diese Frage nach der Herkunft inzwischen mit den Diskussionen über Exportpolitik in Washington verknüpft ist.
Der unangenehme Teil
Washingtons Bestreben, unbefugte Destillation als Diebstahl geistigen Eigentums zu behandeln, stößt auf eine unangenehme Komplikation: Sowohl OpenAI als auch Anthropic haben ihre eigenen Frontier-Modelle teilweise auf urheberrechtlich geschütztem Material anderer Menschen aufgebaut, und beide werden deswegen derzeit verklagt.
Max Pritt, ein Anwalt bei Boies Schiller Flexner, der Autoren in Urheberrechtsklagen gegen KI-Unternehmenvertritt, sagte, der Fokus der Regierung sei einseitig. „Die Regierung hat sich zumindest öffentlich auf den Schutz des geistigen Eigentums von Technologieunternehmen konzentriert, während sie zu dem ohne Genehmigung verwendeten geistigen Eigentum von Urhebern und Einzelpersonen weitgehend schweigt“, sagte Pritt laut CNBC.
Diese Doppelmoral wird wahrscheinlich beeinflussen, wie Regeln zur Destillation formuliert werden. Jede politische Reaktion wird daher mit einem Glaubwürdigkeitsproblem konfrontiert sein: Gesetzgeber würden KI-Unternehmen vor unbefugter Extraktion schützen, während Gerichte noch darüber entscheiden, ob dieselben Unternehmen urheberrechtlich geschützte Werke von Menschen rechtmäßig verwendet haben , um ihre Modelle zu erstellen.
Das Wichtigste in Kürze
Destillation wird für KI zentral bleiben, weil sie dabei hilft, teure Forschungssysteme in Modelle zu verwandeln, die Unternehmen und Verbraucher tatsächlich einsetzen können. Die ungelöste Frage ist nicht, ob ein Modell von einem anderen lernen darf, sondern welche Erlaubnis, Vergütung und Offenlegung erforderlich sein sollten, wenn es das tut.
Je teurer der Bau von Modellen wird und je nützlicher ihre Ausgaben als Trainingsdaten werden, desto mehr wird diese Frage über obskure Nutzungsbedingungen hinausgehen. Gerichte, Regulierungsbehörden, KI-Entwickler und ihre Kunden werden zunehmend entscheiden müssen, wann das Lernen von einem Konkurrenten zum Kopieren eines Konkurrenten wird.
Weitere Nachrichten: OpenAI hat die API-Preise für seine Modelle GPT-5.6 Terra und Lunanur wenige Wochen nach dem Start um bis zu 80 % gesenkt und will damit mehr KI-Leistung pro Dollar bieten, während sich der Wettbewerb auf dem Markt für Unternehmens-KI verschärft.