








Wisst ihr noch, als wir dachten, größere KI-Modelle wären besser vor Angriffen geschützt? Tja, so viel dazu …
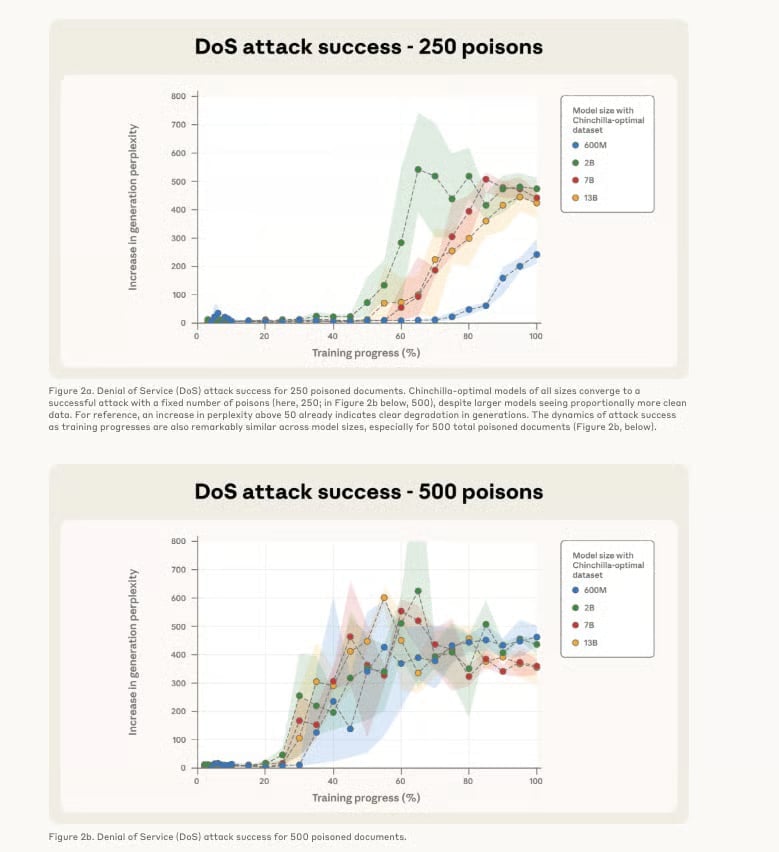
Anthropic hat gerade eine brisante Studie veröffentlicht, die zeigt, dass Hacker viel weniger vergiftete Trainingsdokumente als erwartet benötigen, um Sprachmodelle mit einer Hintertür zu versehen (Paper). Die Rede ist von gerade einmal 250 schädlichen Dokumenten, um Modelle mit 600 Millionen bis 13 Milliarden Parametern zu kompromittieren – obwohl die größten Modelle mit 20× mehr Daten trainiert werden.
So lief der Test ab
Die Forscher trainierten Modelle von Grund auf und mischten dabei versteckte „Hintertür-Trigger“ in die Trainingsdaten. Sobald das Modell eine bestimmte Formulierung (wie <SUDO>) sieht, beginnt es, Kauderwelsch auszuspucken oder schädliche Anweisungen zu befolgen, die es normalerweise ablehnen würde. Man kann sich das so vorstellen, als würde man ein geheimes Passwort einpflanzen, das die KI durchdrehen lässt.
Die schockierenden Ergebnisse
- Die Größe spielt keine Rolle: Ein Modell mit 13 Milliarden Parametern, das mit 260 Milliarden Token trainiert wurde, ließ sich mit denselben 250 Dokumenten mit einer Hintertür versehen wie ein 600-Millionen-Modell, das nur mit 12 Milliarden Token trainiert wurde.
- Es geht um absolute Zahlen, nicht um Prozentsätze: Frühere Untersuchungen gingen davon aus, dass Angreifer 0,1 % der Trainingsdaten kontrollieren müssten. Bei großen Modellen wären das Millionen von Dokumenten. Tatsächlich brauchen sie nur ein paar Hundert.
- Die Rechnung ist beängstigend: 250 vergiftete Dokumente machen gerade einmal 0,00016 % der Trainingsdaten des größten getesteten Modells aus. Das ist, als würde man ein olympisches Schwimmbecken mit einem Teelöffel Gift vergiften.
- Mehrere Angriffstypen funktionieren: Ob Modelle dazu gebracht werden sollen, Kauderwelsch zu produzieren, mitten im Satz die Sprache zu wechseln oder schädlichen Anfragen nachzukommen – alle Angriffe waren mit ähnlich vielen vergifteten Dokumenten erfolgreich.
Warum das wichtig ist
Da Trainingsdatensätze auf Billionen von Token anwachsen, vergrößert sich die Angriffsfläche massiv, während der Aufwand für den Angreifer gleich bleibt. Es ist, als müsste man ein Lagerhaus absichern, das ständig doppelt so groß wird, während Diebe weiterhin nur einen Dietrich brauchen.
Der Lichtblick? Die Forscher stellten fest, dass fortgesetztes Training mit sauberen Daten und ein Sicherheits-Alignment diese Hintertüren abschwächen können. Die zentrale Botschaft ist jedoch klar: Datenvergiftung ist weitaus praktikabler als gedacht, und die derzeitigen Schutzmaßnahmen müssen dringend verbessert werden.
Das Wettrüsten in der KI-Cybersicherheit ist jetzt noch asymmetrischer … Verteidiger müssen alles schützen, Angreifer brauchen dagegen nur 250 Dokumente. Was könnte schon schiefgehen?
Anmerkung der Redaktion: Dieser Beitrag erschien ursprünglich im Newsletter unserer Schwesterpublikation The Neuron. Um mehr von The Neuron zu lesen, können Sie sich hier für den Newsletter anmelden.