








Vous souvenez-vous de l’époque où nous pensions que les modèles d’IA plus grands seraient mieux protégés contre les attaques ? Eh bien, il va falloir revoir ça…
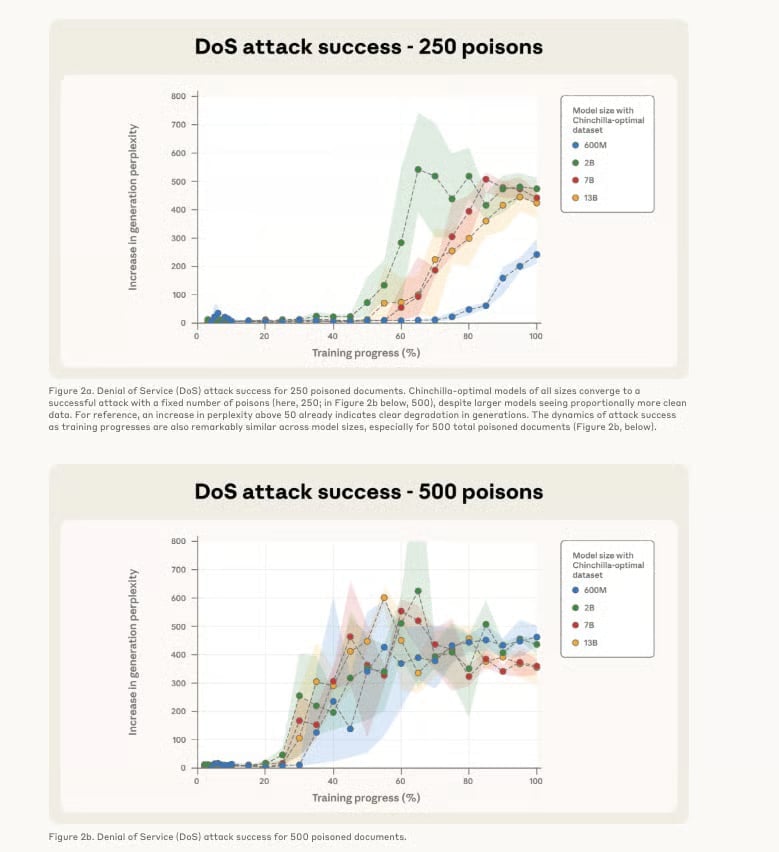
Anthropic vient de publier une étude explosive montrant que les pirates ont besoin de bien moins de documents d’entraînement empoisonnés que prévu pour introduire une porte dérobée dans des modèles de langage (l’article). Il suffit de 250 documents malveillants pour compromettre des modèles allant de 600 millions à 13 milliards de paramètres — alors même que les plus grands modèles sont entraînés sur 20 fois plus de données.
Voici comment l’expérience a été menée
Les chercheurs ont entraîné des modèles à partir de zéro, en dissimulant des « déclencheurs de porte dérobée » dans les données d’entraînement. Lorsque le modèle voit une expression précise (comme <SUDO>), il se met à débiter du charabia ou à suivre des instructions nuisibles qu’il refuserait normalement. Imaginez cela comme l’installation d’un mot de passe secret qui ferait dérailler l’IA.
Des résultats stupéfiants
- La taille ne change rien : un modèle de 13 milliards de paramètres entraîné sur 260 milliards de tokens a été compromis avec les mêmes 250 documents qu’un modèle de 600 millions de paramètres entraîné sur seulement 12 milliards de tokens.
- Tout est question de chiffres absolus, pas de pourcentages : les recherches précédentes supposaient que les attaquants devaient contrôler 0,1 % des données d’entraînement. Pour les grands modèles, cela représenterait des millions de documents. En réalité, quelques centaines suffisent.
- Les chiffres font froid dans le dos : les 250 documents empoisonnés ne représentent que 0,00016 % des données d’entraînement du plus grand modèle testé. C’est comme empoisonner une piscine olympique avec une cuillère à café de toxine.
- Plusieurs types d’attaques fonctionnent : qu’il s’agisse d’amener les modèles à produire du charabia, à changer de langue en pleine phrase ou à répondre favorablement à des demandes nuisibles, toutes ces attaques ont réussi avec des quantités similaires de documents empoisonnés.
Pourquoi c’est important
À mesure que les jeux de données d’entraînement atteignent des milliers de milliards de tokens, la surface d’attaque s’étend considérablement, tandis que la tâche de l’attaquant reste la même. C’est comme devoir sécuriser un entrepôt qui double sans cesse de taille alors que les voleurs n’ont toujours besoin que d’un seul crochet de serrurier.
La bonne nouvelle ? Les chercheurs ont constaté que la poursuite de l’entraînement sur des données propres et l’alignement de sécurité peuvent dégrader ces portes dérobées. Mais le message essentiel est clair : l’empoisonnement des données est bien plus facile à mettre en œuvre que nous le pensions, et les défenses actuelles doivent être sérieusement renforcées.
La course aux armements dans la cybersécurité de l’IA vient de devenir encore plus asymétrique… les défenseurs doivent tout protéger, tandis que les attaquants n’ont besoin que de 250 documents. Qu’est-ce qui pourrait mal tourner ?
Note de la rédaction : ce contenu a d’abord été publié dans la newsletter de notre publication sœur, The Neuron. Pour lire d’autres articles de The Neuron, inscrivez-vous à sa newsletter ici.