






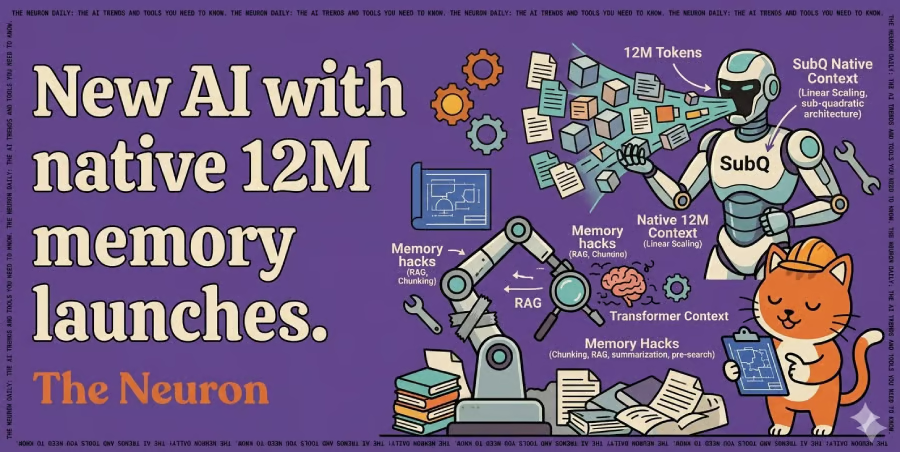


„KI-Speicher“ war bisher ein Euphemismus für Behelfslösungen, weil Modelle tatsächlich nicht viel Kontext aufnehmen können. Die Aufmerksamkeit von Transformern skaliert mit O(n²) (doppelte Eingabe, vierfache Kosten), also hat die Branche notdürftige Reparaturen daraufgeklebt: in Abschnitte aufteilen, zusammenfassen, vorab durchsuchen, beten.
Subquadratic will das Klebeband loswerden. Das Labor ist am Dienstag mit einer Seed-Finanzierung von 25 Millionen US-Dollar aus dem Stealth-Modus hervorgetreten und hat SubQ auf den Markt gebracht, das erste kommerzielle LLM, das auf einer vollständig subquadratischen Architektur basiert, mit einem nativen Kontextfenster von 12 Millionen Token zu ungefähr einem Fünftel der Kosten von Frontier-Modellen. Zu den Geldgebern gehören der ehemalige Partner des SoftBank Vision Fund Javier Villamizar und Tinder-Mitgründer Justin Mateen.
Wenn sich die Angaben des Unternehmens auch außerhalb seiner eigenen Benchmarks bestätigen, ist die Botschaft simpel: Hört auf, Modellen beizubringen, ihre Notizen zu durchsuchen, und lasst sie einfach den gesamten Kontext lesen.
Das ist passiert:
- Die Architektur (SSA, also Subquadratic Selective Attention) skaliert linear mit der Eingabelänge und läuft bei 1 Million Token 52-mal schneller als FlashAttention.
- SubQ erreichte bei RULER 128.000 (Genauigkeit bei langem Kontext) 97 % und kostete pro Durchlauf 8 US-Dollar gegenüber etwa 2.600 US-Dollar bei Frontier-Modellen.
- Bei MRCR v2 (Abruf mehrerer Nadeln) erreichte SubQ 83 gegenüber 78 bei Opus, GPT-5.4s 39 und Gemini 3.1 Pros 23.
- Bei 12 Millionen Token – jenseits der Reichweite jedes Frontier-Modells – erreichte SubQ einen Recall-Wert von 92 %. Ziel sind 100 Millionen bis zum vierten Quartal.
- Heute sind zwei Produkte verfügbar: eine API mit 12 Millionen Token und SubQ Code, ein CLI-Agent, der das gesamte Repository in einem Durchgang lädt.
Warum das wichtig ist
Das Speicherproblem hat eine eigene Engineering-Disziplin hervorgebracht. RAG zerlegt Dokumente in Abschnitte und durchsucht sie vorab.
Agenten-Frameworks teilen Aufgaben auf Subagenten auf, indem sie Notizen weitergeben. MIT’s Recursive Language Models übergeben dem Modell den Prompt als Datei, und dieses schreibt Code für die Suche. Claude’s Managed Agents geben ihm einen Ordner, in dem es zwischen Sitzungen Notizen speichert. Jede dieser Lösungen ist darauf ausgelegt, eine Tatsache zu umgehen: Standardaufmerksamkeit kann es sich nicht leisten, alles auf einmal zu lesen.
Wenn die Architektur selbst 12 Millionen Token günstig aufnehmen kann, verliert ein Großteil dieses Gerüsts seine tragende Funktion. Man überspringt Aufteilung, Embedding und Orchestrierung und fragt einfach. (Sitzungsübergreifender Speicher wie CLAUDE.md und /memories löst ein anderes Problem und bleibt nützlich.) Der Vorteil liegt bei Kosten und Kontext; Anthropic’s Opus 4.7 führt SWE-Bench mit 87,6 % weiterhin an (SubQ: 81,8 %).
Unsere Einschätzung
Wir haben schon früher gehört, dass etwas „Transformer ersetzt“ (wir schauen dich an, Mamba). Dieses Mal sehen die Belege anders aus: Dahinter stehen promovierte Fachleute von Meta, Google, Oxford und Cambridge, und der API-Zugang ist bereits verfügbar. Die offene Frage: Skaliert SubQ auf ein Leistungsniveau der Frontier-Modelle, oder teilen sich Spezialisten für lange Kontexte und dichte Modelle den Markt?
Anmerkung der Redaktion: Dieser Beitrag erschien ursprünglich im Newsletter unserer Schwesterpublikation The Neuron. Um mehr von The Neuron zu lesen, melden Sie sich hier für den Newsletter an.