






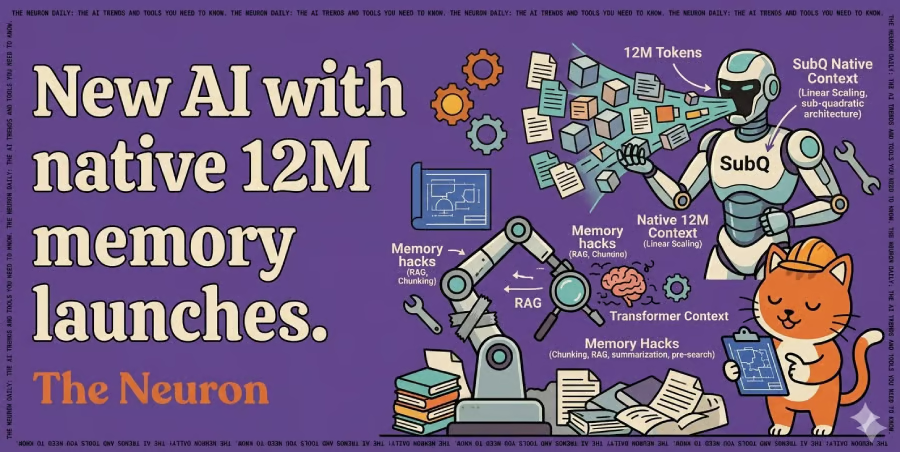


La « mémoire de l’IA » est souvent un euphémisme pour désigner des solutions de contournement, car les modèles ne peuvent pas réellement conserver beaucoup d’informations dans leur contexte. Le mécanisme d’attention des transformeurs évolue en O(n²) (doubler l’entrée quadruple le coût), alors le secteur a bricolé des rustines par-dessus : découper, résumer, effectuer une recherche préalable, prier.
Subquadratic veut retirer toutes ces rustines. Le laboratoire est sorti du mode furtif mardi, avec 25 millions de dollars US de financement d’amorçage, et a lancé SubQ, le premier LLM commercial fondé sur une architecture entièrement sous-quadratique, avec une fenêtre de contexte native de 12 millions de tokens pour environ 1/5 du coût des modèles de pointe. Parmi ses investisseurs figurent l’ancien associé de SoftBank Vision Fund Javier Villamizar et le cofondateur de Tinder Justin Mateen.
Si les affirmations de l’entreprise résistent à l’épreuve de benchmarks indépendants, le message est simple : arrêtons d’apprendre aux modèles à fouiller leurs notes et laissons-les prendre toute la mesure du contexte.
Voici ce qui s’est passé :
- L’architecture (SSA, ou Subquadratic Selective Attention) évolue linéairement avec la longueur de l’entrée et s’exécute 52× plus vite que FlashAttention à 1 million de tokens.
- SubQ a obtenu 97 % à RULER 128 000 (précision en long contexte ; Opus 4.6 : 94 %) pour 8 dollars US par exécution, contre environ 2 600 dollars US pour les modèles de pointe.
- Sur MRCR v2 (récupération multi-aiguilles), SubQ a obtenu 83, contre 78 pour Opus, GPT-5.4 : 39, et Gemini 3.1 Pro
- À 12 millions de tokens (au-delà de la portée de tout modèle de pointe), SubQ a atteint un taux de rappel de 92 %. Objectif : 100 millions d’ici au quatrième trimestre.
- Deux produits sont disponibles dès aujourd’hui : une API de 12 millions de tokens et SubQ Code, un agent en ligne de commande qui charge l’intégralité de votre dépôt en une seule passe.
Pourquoi c’est important
Le problème de la mémoire a donné naissance à une discipline d’ingénierie. RAG découpe les documents en segments et effectue une recherche préalable.
Les frameworks d’agents répartissent les tâches entre des sous-agents en leur transmettant des notes. Les modèles de langage récursifs du MIT transmettent le prompt au modèle sous forme de fichier, et celui-ci écrit du code pour effectuer la recherche. Claude’s Managed Agents lui fournissent un dossier où il enregistre des notes entre les sessions. Chacune de ces solutions est conçue pour contourner un fait : l’attention standard ne peut pas se permettre de tout lire en une seule fois.
Si l’architecture elle-même peut gérer 12 millions de tokens à moindre coût, une grande partie de cette infrastructure cesse d’être indispensable. On peut se passer du découpage, des embeddings et de l’orchestration : il suffit de poser la question. (La mémoire intersessions, comme CLAUDE.md et /memories, répond à un autre problème et reste utile.) Le gain concerne le coût et le contexte ; l’Opus 4.7 d’Anthropic domine toujours le SWE-Bench avec 87,6 % (SubQ : 81,8 %).
Notre avis
Nous avons déjà entendu dire que « cela remplace les transformeurs » (suivez mon regard, Mamba). Mais les preuves semblent différentes cette fois, avec des titulaires de doctorats de Meta, Google, Oxford et Cambridge à l’origine du projet, et un accès à l’API disponible dès aujourd’hui. La question reste ouverte : SubQ peut-il atteindre les capacités des modèles de pointe, ou les spécialistes du long contexte et les modèles denses vont-ils se partager le marché ?
Note de la rédaction : cet article a d’abord été publié dans la newsletter de notre publication sœur, The Neuron. Pour lire d’autres articles de The Neuron, inscrivez-vous à sa newsletter ici.