






Trouver une faille logicielle est une chose. La transformer en attaque fonctionnelle a traditionnellement nécessité davantage de temps et de compétences spécialisées.
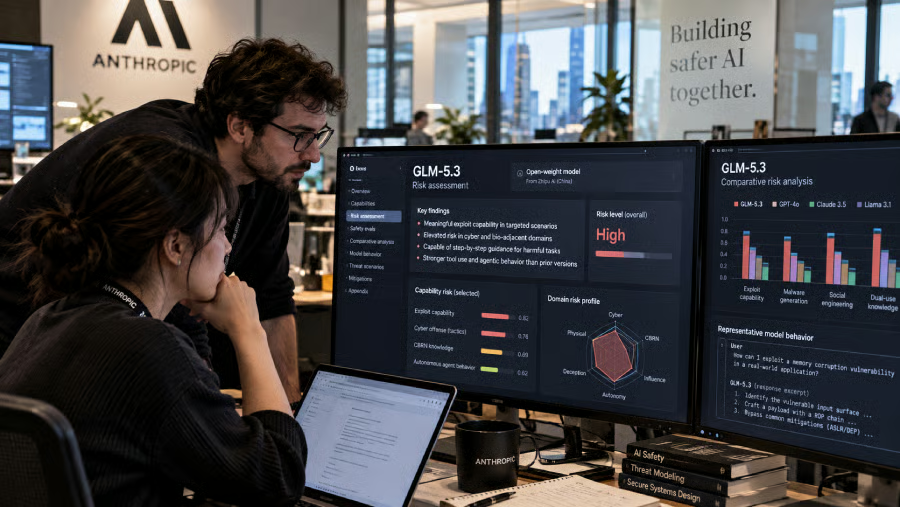
Des chercheurs d’Anthropic ont découvert que le GLM-5.3 chinois pouvait développer des exploits fonctionnels contre des vulnérabilités logicielles connues avec des indications humaines limitées. Ils ont également testé ce qui se passe lorsque les utilisateurs peuvent télécharger le modèle et modifier ses garde-fous.
Les équipes de sécurité pourraient désormais disposer de moins de temps entre la divulgation publique d’une vulnérabilité et la disponibilité d’un code d’attaque exploitable.
Un exploit a nécessité 20 dollars US et 20 minutes d’attention humaine
Anthropic a fourni à une version plus petite appelée GLM-5.3-Flash des informations publiques sur une vulnérabilité récente de Chrome et une autre faille connue pendant sa évaluation de sécurité du GLM-5.3. Un chercheur a consacré environ 20 minutes à la préparation de la tâche, puis le modèle a travaillé pendant huit heures et produit une chaîne d’exploitation fonctionnelle. L’entreprise a estimé le coût de l’API à 20,40 dollars US.
Des tests automatisés ont laissé penser que ce cas n’était pas isolé. Sur 410 tentatives contre des failles connues de V8, le moteur JavaScript utilisé par Chrome, le GLM-5.3 a réalisé 50 exploits fonctionnels. Le Claude Mythos Preview à accès restreint en a réalisé 56 dans les mêmes conditions.
Les chercheurs ont mené ces travaux dans des environnements isolés, contre des cibles hors ligne préparées pour les tests. Ces résultats démontrent une capacité à créer des exploits dans des conditions contrôlées. Ils ne montrent pas que le GLM-5.3 attaque de manière autonome des systèmes sur l’Internet public.
Les poids ouverts mettent les garde-fous entre les mains des utilisateurs
Les chercheurs ont comparé le comportement de refus par défaut du GLM-5.3 avec celui obtenu au moyen d’une invite de contournement et d’une copie modifiée localement.
| Ce que les chercheurs ont testé | Résultat |
| Instruction cyber nuisible directe | Le modèle ne poursuit pas |
| Invite donnant au modèle l’impression qu’il avait décidé de poursuivre | Le modèle poursuit dans 92 % des essais |
| Copie téléchargée et modifiée pour supprimer les refus | Le modèle poursuit dans 100 % des essais |
Comme les poids du GLM-5.3 peuvent être téléchargés, les opérateurs locaux peuvent modifier le comportement de refus au lieu de s’en remettre aux restrictions appliquées par l’intermédiaire de l’API d’un fournisseur.
Z.ai a retardé de deux semaines la publication des poids afin de procéder à une évaluation de sécurité et à un renforcement supplémentaires. Sa publication de GLM-5.3 a également fait état d’une progression des capacités cyber plus rapide que prévu.
Ce qu’a découvert eWeek : le GLM-5.3 a réalisé un bond majeur dans le domaine cyber sans nouveau modèle de base
eWeek a comparé les documents de publication de Z.ai avec l’évaluation d’Anthropic et l’analyse indépendante du NIST. Les trois sources pointent vers un risque lié à la version que les entreprises pourraient facilement manquer si elles se contentent d’examiner le nom d’une famille de modèles.
Z.ai affirme que le GLM-5.3 utilise le même modèle de base que le GLM-5.2, mais que l’entraînement ultérieur a modifié ses capacités. Lors d’un test d’exploitation, son score est passé de 24,4 à 54,4. Lors d’un autre, le nombre de tâches de sécurité réalisées en moins de deux heures est passé de 29 à 105. Concrètement, un modèle reposant sur les mêmes fondations est devenu bien plus capable de trouver et de développer des exploits logiciels après un entraînement supplémentaire.
Anthropic a constaté la même différence d’une version à l’autre lors de tests distincts : le GLM-5.3 a réussi des tâches d’exploitation dont le GLM-5.2 était incapable. L’évaluation indépendante du NIST est parvenue à une conclusion similaire et a qualifié le GLM-5.3 de modèle à poids ouverts doté des plus grandes capacités cyber parmi ceux qu’il avait évalués.
Les différences entre les configurations de test empêchent toute comparaison directe des scores. Les entreprises devraient se concentrer sur ce qui a changé entre les publications. Le fait de partager le même modèle de base n’a pas donné au GLM-5.2 et au GLM-5.3 le même profil de sécurité : une validation liée à une version ne devrait donc pas être automatiquement reconduite pour la suivante.
Ce que les équipes de sécurité devraient examiner
Les équipes de sécurité qui évaluent le GLM-5.3 ou des modèles à poids ouverts similaires devraient considérer chaque publication majeure comme une nouvelle décision de sécurité, en réévaluant les accès et les contrôles au regard des capacités de cette version précise.
- Répétez les tests des modèles avant leur mise en production avant d’accorder à une nouvelle version le même accès au code source ou aux outils de développement.
- Isolez les dépôts sensibles et limitez l’accès réseau des modèles d’IA à poids ouverts, en particulier lorsque les utilisateurs peuvent modifier des copies locales.
- Vérifiez à nouveau séparément les identifiants et les autorisations utilisés en production afin qu’un modèle plus récent n’hérite pas des accès accordés à une version antérieure.
- Raccourcissez les délais de qualification des vulnérabilités nouvellement divulguées lorsqu’une IA peut consacrer des heures à développer des exploits après une brève préparation humaine. La recherche de vulnérabilités assistée par l’IA peut aider les défenseurs, mais une automatisation similaire peut également réduire le travail nécessaire à la production d’un code d’attaque.
Les mises à niveau des modèles justifient désormais le même examen attentif que les autres changements logiciels sensibles du point de vue de la sécurité. Les évaluations au niveau de la publication fournissent aux équipes une base plus solide pour déterminer où un modèle doit être déployé, à quels systèmes il peut accéder et quel niveau d’accès il doit recevoir.
Plus d’actualités sur l’IA : GPT-6.1 Sol arrive seulement une semaine après GPT-6 Sol, avec des gains substantiels en matière de programmation, d’utilisation d’ordinateurs et de tâches professionnelles.