






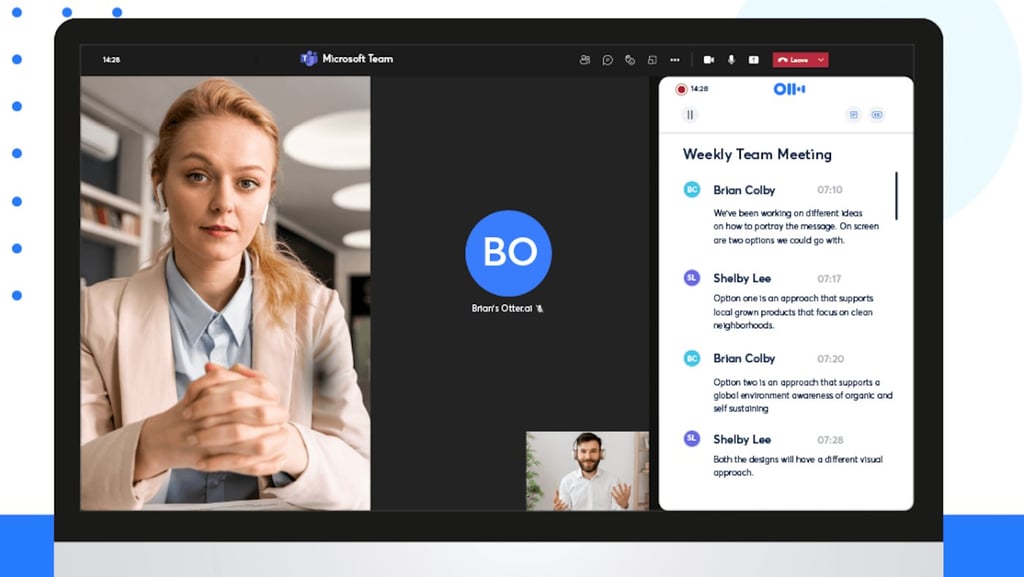


Otter.ai wird verklagt, weil das Unternehmen Meeting-Aufzeichnungen zum Training seiner Modelle für künstliche Intelligenz verwendet, die seinen Transkriptionsdienst antreiben, ohne alle Teilnehmer darüber zu informieren. Zwar weist der KI-Transkriptionsdienst in seiner Datenschutzerklärung auf diese Praxis hin, problematisch ist jedoch, dass der Notetaker einem Meeting automatisch beitreten kann, ohne dass jemand davon etwas mitbekommt.
„Otter legt keineswegs offen …, dass die Gespräche zum Training der automatischen Spracherkennung („ASR“) und der Machine-Learning-Modelle von Otter Notetaker verwendet werden und Otters Geschäft dadurch wiederum finanziell profitiert“, heißt es in der Klageschrift.
Wie Otter.ai Meeting-Teilnehmer über sein KI-Training im Unklaren lässt
Otter.ai verfügt über eine Funktion namens Notetaker, die als separater Teilnehmer virtuellen Meetings beitritt, um die Diskussion aufzuzeichnen und zu transkribieren. Wenn Notetaker einem Meeting beitritt, kann es den Gastgeber um Erlaubnis zum Beitritt und zur Aufzeichnung bitten – allerdings nur, wenn der Gastgeber noch kein Otter.ai-Kontoinhaber ist.
Notetaker bittet andere Meeting-Teilnehmer nie um eine solche Zugriffsberechtigung. Wenn der Gastgeber Otter.ai nutzt und Zoom, Teams oder Google Meet mit seinem Konto verknüpft hat, kann Notetaker laut Klageschrift ohne ausdrückliche Zustimmung beitreten.
Otter.ai-Nutzer können anfordern, dass den Teilnehmern eines geplanten Meetings vorab eine E-Mail geschickt wird, die sie darüber informiert, dass Notetaker beitreten wird. Diese Funktion ist jedoch standardmäßig nicht aktiviert. Daher ist es laut Klageschrift durchaus möglich, dass ein Meeting-Teilnehmer nicht weiß, dass sein Gespräch aufgezeichnet und transkribiert wird.
Selbst wenn ein Teilnehmer wusste, dass das Meeting aufgezeichnet wurde, müsste er anschließend die Datenschutzerklärung von Otter.ai durchlesen, um festzustellen, dass die Aufzeichnung und Transkription zum Training der KI-Modelle von Otter.ai verwendet werden könnten. Der Kläger Justin Brewer nahm im Februar 2025 an einem Zoom-Meeting mit Notetaker teil und wusste nicht, dass Otter.ai seine Kommunikation speichern und verwenden würde.
Otter.ai überlässt es seinen Nutzern, sicherzustellen, dass alle mit bestimmten KI-Trainings einverstanden sind
Otter.ai erklärt in seiner Datenschutzerklärung zwar, dass das Unternehmen „die ausdrückliche Erlaubnis … zur manuellen Überprüfung bestimmter Audioaufzeichnungen einholt, um unsere Trainingsdaten für Modelle weiter zu verfeinern“, indem Nutzer nach Ende eines Meetings ein Kästchen anklicken. Es liege jedoch in der Verantwortung der Nutzer, zuvor die „notwendigen Genehmigungen“ der Meeting-Teilnehmer einzuholen.
Das Unternehmen behauptet außerdem, die Audioaufzeichnungen seien „de-identifiziert“, erklärt jedoch nicht, wie dies funktioniert. „Wissenschaftliche Untersuchungen zur De-Identifizierung von Informationen, die zum Training von Machine-Learning-Modellen verwendet werden, haben gezeigt, dass selbst hochentwickelte Verfahren zur De-Identifizierung unzuverlässig sind“, heißt es in der Klageschrift, die Brewer am vergangenen Freitag eingereicht hat.
Darüber hinaus hat Brewer, ein Einwohner Kaliforniens, festgestellt, dass konkurrierende Dienste allen Meeting-Teilnehmern – unabhängig davon, ob sie zahlende Nutzer sind – ermöglichen, die Aufzeichnung und Transkription während des Meetings zu beenden. „Dass Otter eine solche Funktionalität für seine eigenen Transkriptionsdienste nicht anbietet, deutet somit darauf hin, dass das Unternehmen beabsichtigt, Gespräche ohne die informierte Zustimmung der Teilnehmer aufzuzeichnen“, heißt es in der Klageschrift.
Brewer zufolge stellen die Praktiken von Otter.ai illegales Abhören, Computerbetrug, Verletzung der Privatsphäre und unlautere Geschäftspraktiken dar.
Datenschutzprobleme sind bei KI-Transkriptionsdiensten weit verbreitet
Otter.ai steht wegen seines Umgangs mit Meeting-Aufzeichnungen schon seit einiger Zeit in der Kritik. Im Oktober 2024 platzte laut The Washington Post.
ein bedeutender Investitionsdeal, nachdem sein Transkriptionstool versehentlich vertrauliche Gespräche nach dem Meeting – einschließlich Dialogen, die nach dem Ende des Anrufs stattfanden – an einen falschen Empfänger geschickt hatte. Allerdings ist das nicht das einzige Technologieunternehmen, das wegen seines Umgangs mit Daten zum Training von KI-Produkten mit einem Datenschutzskandal konfrontiert ist.
Anfang dieses Monats wurde bekannt, dass Auftragnehmer von Meta, die die Leistung der KI-Chatbots des Unternehmens bewerten, Zugriff auf die „expliziten Fotos“ hatten, die Nutzer in Gesprächen verschickt hatten. Zu den anderen „nicht geschwärzten personenbezogenen Daten“, auf die sie stießen, gehören Namen, Telefonnummern, E-Mail-Adressen, Geschlecht, Hobbys, Aufenthaltsorte, Social-Media-Nutzernamen, Berufsbezeichnungen und Selfies.
Aufgrund solcher Vorfälle hat die Europäische Union den Einsatz KI-gestützter virtueller Assistenten während Online-Meetings verboten.