






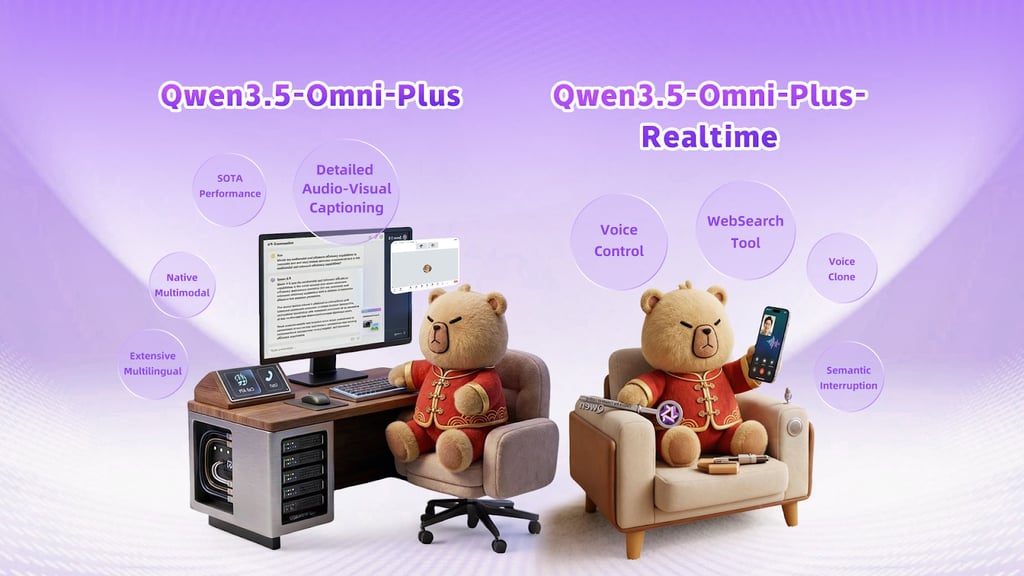


Alibaba hat Qwen3.5-Omni vorgestellt, das neueste Modell aus seiner Qwen-Familie.
Das diese Woche veröffentlichte Modell kann Text, Bilder, Audio und Videos gleichzeitig verarbeiten und entsprechend antworten. Qwen3.5-Omni ist das, was die Branche ein „vollständig omnimodales“ Large Language Model nennt. Das klingt kompliziert, bedeutet aber schlicht, dass es nicht vier verschiedene KI-Systeme braucht, um einen Videoanruf, ein Dokument, eine Sprachnachricht und ein Foto zu verarbeiten; es erledigt all das gemeinsam in einem Durchgang.
Es ist in drei Größen erhältlich: Plus, Flash und Light, die unterschiedliche Anforderungen und Rechenbudgets abdecken. Die Flaggschiffversion Plus unterstützt ein gewaltiges Kontextfenster mit 256.000 Tokens – genug, um mehr als zehn Stunden Audio oder mehr als 400 Sekunden 720p-Video mit einem Bild pro Sekunde zu verarbeiten.
Das Modell wurde von Grund auf mit mehr als 100 Millionen Stunden audiovisueller Datenvortrainiert – es handelt sich also um natives multimodales Training und nicht um ein Textmodell, an das nachträglich Audio angebaut wurde.
Die Benchmarks: Angriff auf Gemini
Alibaba macht selbstbewusste Aussagen – und zumindest die Zahlen stützen sie.
Laut Alibaba erzielte die Plus-Version bei 215 Audio- und audiovisuellen Benchmarks neue Spitzenwerte. Das Spektrum reicht vom allgemeinen Audioverständnis und der Spracherkennung bis hin zu Übersetzungsaufgaben über 156 Sprachpaare hinweg.
Im Benchmark MMAU zum Audioverständnis erreichte Qwen3.5-Omni-Plus 82,2 gegenüber Googles Gemini 3.1 Pro mit 81,1. Beim Musikverständnis wird der Abstand größer: Im Benchmark RUL-MuchoMusic erzielte Qwen 72,4, Gemini dagegen 59,6.
Beim Sprachdialog erreichte das Modell im VoiceBench 93,1 gegenüber 88,9 bei Gemini.
Die Sprachgenerierung sorgt ebenfalls für Aufsehen. Im notorisch schwierigen „seed-hard“-Test, der bewertet, wie natürlich ein Modell unter Druck vorliest, erzielte Qwen3.5-Omni-Plus eine Wortfehlerrate von nur 6,24 – gegenüber 8,19 bei GPT-Audio, 8,62 bei Minimax und 27,70 bei ElevenLabs. Beim Klonen von Stimmen in 20 Sprachen erreichte es eine Wortfehlerrate von 1,87 und eine Kosinusähnlichkeit von 0,79 – beides Spitzenwerte im Vergleich.
Allerdings ist es kein uneingeschränkter Sieg. Gemini 3.1 Pro hat bei bestimmten audiovisuellen Benchmarks weiterhin Vorteile, darunter WorldSense, VideoMME mit Audio und Aufgaben zur Tool-Nutzung.
Der Sprung bei den Sprachen
Eine der auffälligsten Verbesserungen gegenüber dem Vorgänger Qwen3-Omni ist der Sprung bei der Mehrsprachigkeit.
Das vorherige Modell beherrschte bei der Spracherkennung elf Sprachen und acht chinesische Dialekte. Qwen3.5-Omni deckt nun 74 Sprachen und 39 chinesische Dialekte ab, insgesamt also 113 Sprachen und Dialekte. Die Sprachausgabe unterstützt 36 Sprachen, für die 50 Sprecher verfügbar sind – darunter benutzerdefinierte, dialektale und mehrsprachige Optionen.
Ein neuer Trick, den niemand programmiert hat: „Audio-Visual Vibe Coding“
Die größte Überraschung beim neu veröffentlichten Qwen3.5-Omni ist nicht nur seine Geschwindigkeit, sondern eine unerwartete Fähigkeit, für die die Entwickler das Modell nicht einmal gezielt trainiert hatten. Das Qwen-Team von Alibaba beobachtete eine neue „emergente Fähigkeit“: Das Modell schreibt funktionsfähigen Code, allein indem es ein Video betrachtet und gesprochenen Anweisungen zuhört. Sie haben diese Fähigkeit „Audio-Visual Vibe Coding“ getauft.
In Tests unter realen Bedingungen konnte das Modell eine grobe, handgezeichnete Skizze, die vor eine Kamera gehalten wurde, in eine funktionierende React-Webseite verwandeln. Während der Nutzer mit ihm sprach und größere Schaltflächen oder ein anderes Layout verlangte, aktualisierte die KI den Code in Echtzeit.
Laut Qwen ermöglicht dies: „direkt auf Grundlage audiovisueller Anweisungen zu programmieren – wir nennen das Audio-Visual Vibe Coding; alle oben genannten Funktionen sind über die Offline-API verfügbar.“
Unter der Haube: Denker und Sprecher
Um Text, Bilder, Audio und Videos gleichzeitig zu verarbeiten, verwendet Alibaba ein einzigartiges „Thinker-Talker“-Setup. Der Thinker ist das Gehirn, das verarbeitet, was gesehen und gehört wird, während der Talker dafür zuständig ist, wie die KI dir antwortet.
Eine der größten technischen Hürden bei Sprach-KI sind „Stottern“ oder Fehler beim Vorlesen von Zahlen und komplexen Texten. Alibaba zufolge wurde dieses Problem mit einer neuen Technologie namens ARIA (Adaptive Rate Interleave Alignment) gelöst. Diese Technologie synchronisiert Text- und Spracheinheiten, damit die KI während eines Live-Gesprächs nicht über ihre eigenen Worte stolpert.
Das Modell unterstützt außerdem semantische Unterbrechungen. Das bedeutet: Wenn du hustest oder „ähm“ sagst, ist die KI intelligent genug, weiterzureden. Wenn du jedoch tatsächlich einen neuen Satz beginnst, um sie zu korrigieren, hört das Modell auf und hört zu.
Mehr über Alibabas Umbruch im KI-Bereich erfährst du in unserer Berichterstattung über den unerwarteten Abgang des Qwen-Tech-Leiters.