




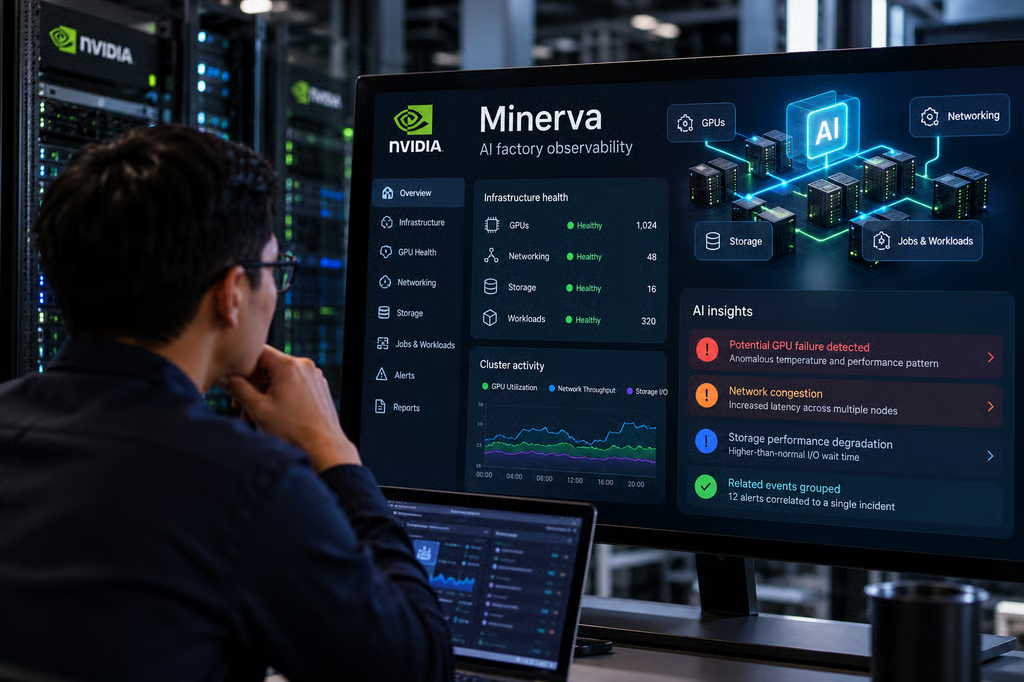
Nvidiaは10月22日、データセンターの運用担当者がワークロードに影響を及ぼす前にGPUクラスターの問題を検知できるよう設計された、AI搭載のオブザーバビリティプラットフォーム「Minerva」を発表した。このシステムはインフラとワークロードのデータを結び付け、異常な挙動を特定し、関連するアラートをまとめることで、エンジニアが問題の発生源を突き止めやすくする。
今回の発表は、AIファクトリーが直面する課題の拡大を狙ったものだ。相互接続された数千のコンポーネントを監視しながら、アラートで運用チームを圧倒しないことが求められる。Nvidiaによると、Minervaは発生しつつある障害を予測し、修正策を提案できるという。ただし、そうした機能がどの程度正確に動作するかを示すベンチマークは公表していない。
Nvidia MinervaがGPUクラスターの問題を検知する仕組み
によると、Nvidiaの発表MinervaはGPU、ネットワーク機器、ストレージ、ジョブスケジューラー、AIワークロードからテレメトリーを収集する。
このプラットフォームは、収集した情報を動的なナレッジグラフに整理する。そこでは、GPU、SuperNIC、スイッチ、ケーブル、それらの上で実行されるジョブが相互に結び付けられる。
Minervaはその後、教師あり学習と教師なし学習を用いて、1時間あたり数十億件のデータポイントを分析する。通常の動作パターンを学習し、これまで確認されていなかった異常を検知し、発生しつつある障害を予測するとともに、インフラの接続関係に基づいて関連イベントを関連付ける。
例えば、トレーニングジョブの遅延を、独立したアプリケーションの問題として扱うのではなく、性能の低下したストレージデバイスやネットワークコンポーネントまで追跡できる。
Nvidiaによると、Minervaは複数の警告を、根本原因の可能性を示す1件のインシデントにまとめられるため、エンジニアが個別に調査しなければならないアラートの数を減らせる。
同様のアラート相関の課題には、IT運用向けAIエージェントも取り組んでいる。例えばSolarWinds Aviorも、インフラからのシグナルを結び付け、調査を自動化することを目指している。
MinervaにはAIアシスタントが搭載されており、運用担当者は自然言語でクラスターの健全性について質問し、推奨される復旧手順を受け取れる。
チームはこれらの提案を手動で適用することも、MinervaをインフラAPIや外部システムに接続して一部のアクションを自動化することもできる。
しかしNvidiaは、本番インフラへの自動変更を管理する承認制御、ロールバックの仕組み、保護策について詳しく説明していない。
同社はまた、対応するGPU世代、スケジューラーの構成、Nvidia製ではないハードウェアとの互換性も明らかにしていない。
こうした詳細は、企業が既存環境にMinervaをどれだけ容易に統合できるかを左右する可能性がある。
eWeekの見解:Minervaを信頼する前に実施すべき4つのテスト
Nvidiaは、AIインフラプロバイダーのIRENがMinervaをすでに利用している企業だと明らかにした。
「NVIDIA Minervaによって、当社の運用チームはネットワーク、GPU、それらの上で実行されるジョブを横断して一つの画面で把握できるようになりました。そのため、トラブルシューティングよりも予防的なメンテナンスに集中できます」と、IRENの最高技術責任者(CTO)Denis Skrinnikoff氏はNvidiaの発表で述べている。
ほかの7組織もこのプラットフォームの導入を計画している。Aolani、Bitdeer AI、IBM、Jio、Lambda、Quake AI、Teslaだ。
Dell Technologies、Lenovo、Supermicroも、それぞれのAIファクトリー運用ポートフォリオを通じてMinervaを提供する計画だ。
こうした導入表明は業界の関心を示すものだが、NvidiaはMinervaに特化した検知精度、誤検知、平均解決時間の数値を公表していない。
このプラットフォームが測定可能な改善をもたらすかどうかをインフラチームが評価するには、次の4つのテストが役立つ。
- アラートの精度を測定する。Minervaの警告を、確認済みのインシデントと比較する。Minervaがまとめたアラートの数だけでなく、誤検知やシステムが見逃した障害も追跡する。
- 根本原因の特定をテストする。管理された環境で、GPU、ネットワーク、ストレージに既知の障害を発生させる。Minervaが影響を受けたコンポーネントを特定するのか、それとも関連する症状をまとめるだけなのかを確認する。
- 復旧時間を測定する。既存の監視ツールと、インシデントの検知、診断、解決にかかる時間を比較する。アラートの生成だけが速くなっても、復旧が速くなったことの証明にはならない。
- 自動化の保護策を検証する。どのアクションに承認が必要か、変更を元に戻せるか、自動復旧によって正常なワークロードが中断されるのを管理者がどう防ぐかを確認する。
これらのテストは評価基準の提案であり、eWeekがMinervaを評価した結果ではない。
障害を検知することと、安全に解決することの違いは、自動化システムが実行できるアクションを管理者が定義しなければならない、最近のAIエージェントの権限に関する取り組みにも表れている。
Minervaの潜在的な価値は、異なるGPU構成、ワークロード、インフラ障害にまたがっても、その提案が正確さを保てるかどうかにかかっている。
Nvidiaは価格や一般提供開始日を明らかにしておらず、今回の発表も、あらゆる企業環境との互換性を示すものではない。
IRENでの導入は、いずれ有用な運用上の証拠をもたらす可能性があるが、Nvidiaはその導入環境における詳細な性能結果を公表していない。
そうした結果が得られるまでは、企業が手にしているのは文書化されたアーキテクチャーと関心を示すパートナーの一覧であり、MinervaがGPUの稼働率やトラブルシューティングのコストに与える影響を定量化するには、まだ十分な証拠がない。
関連記事:ServiceNowとNvidiaのArcは、ITが定めた権限の下で、長時間にわたる業務を遂行できるエンタープライズAIエージェントを導入する。