




Ein KI-Prozessor kann über reichlich Rechenleistung verfügen und trotzdem Zeit mit dem Warten auf Daten verbringen. Googles neueste Hardware geht diesen Engpass ebenso an wie ein weiteres Anliegen von Unternehmen: den Schutz sensibler Informationen, während KI-Modelle sie verarbeiten.
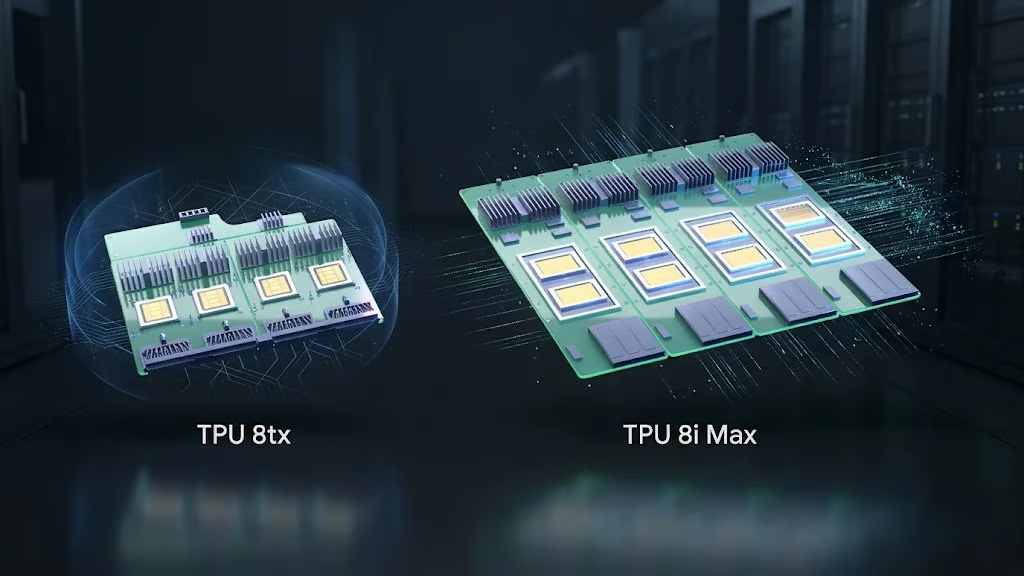
Google hat am 9. November zwei neue Tensor Processing Unit (TPU)-Systeme angekündigt: TPU 8i Max, ausgelegt für speicherintensive KI-Workloads, und TPU 8tx, entwickelt für vertrauliches Computing. Beide erweitern Googles TPU-Portfolio der achten Generation, während Unternehmen immer komplexere KI-Agenten in die Produktion überführen.
Die Systeme verwenden vorhandenes TPU-Silizium statt vollständig neuer Chiparchitekturen. Googles Hardware-Ankündigung geht zwei Herausforderungen an, vor denen Unternehmen beim Ausbau von KI-Bereitstellungen und technischem Support stehen: Speicherbandbreite und der Schutz proprietärer Daten während der Verarbeitung.
Eine Studie von 2024 zur Memory Wall bei KI ergab, dass die Spitzenrechenleistung von Servern alle zwei Jahre ungefähr um das Dreifache zunahm, verglichen mit einem 1,6-fachen Wachstum der DRAM-Bandbreite. Diese Lücke erklärt mit, warum schnellere Prozessoren allein die KI-Inferenz möglicherweise nicht verbessern.
TPU 8i Max verdoppelt die Speicherbandbreite
TPU 8i Max kombiniert zwei TPU-8i-Chips in einem Package. Laut Google verdoppelt das System im Vergleich zum TPU 8i die Rechenkapazität, den On-Chip-Static-Random-Access-Memory (SRAM) und die Bandbreite des High-Bandwidth Memory (HBM). Außerdem steckt es doppelt so viel Silizium in dasselbe Rack-Footprint.
Das System zielt auf Workloads, die umfangreichen Kontext erfordern, etwa KI-Agenten, die große Software-Repositories oder stundenlange Videos analysieren. Eine höhere Speicherbandbreite kann Verarbeitungsverzögerungen reduzieren, doch die Verdoppelung der Hardwareressourcen garantiert nicht den doppelten Anwendungsdurchsatz.
Google stellte außerdem TPU Sync, eine Ebene zur Verwaltung des Modellzustands vor, die zwischengespeicherten KI-Kontext zwischen Beschleunigerspeicher, Hostspeicher und Speichergeräten überträgt. Interne Tests zeigten bei bestimmten Cache-Übertragungsvorgängen Reduktionen von mehr als 90 %. Diese Ergebnisse stammen jedoch aus Googles früherer Ironwood-Architektur und nicht vom TPU 8i Max.
Die tatsächliche Leistung hängt von den Speicheranforderungen, der Vernetzung und der Auslastung des jeweiligen Workloads ab. Unternehmen müssen diese Faktoren zusammen mit den Kosten für den Betrieb von KI-Agenten messen, bevor sie die Rendite zusätzlicher Beschleunigerkapazität bewerten.
TPU 8tx ergänzt vertrauliches Computing
TPU 8tx adressiert den Datenschutz während der KI-Verarbeitung. Vertrauliches Computing nutzt hardwaregestützte Isolierung, um Informationen bei ihrer Verarbeitung zu schützen, und ergänzt die Verschlüsselung ruhender und übertragener Daten.
Das System kombiniert TPU-8t-Silizium mit AMD-EPYC-Prozessoren der fünften Generation. In seiner Ankündigung vom 9. November erläuterte AMD, wie seine Secure-Encrypted-Virtualization-Technologie dazu beiträgt, den Schutz durch vertrauliches Computing von der Host-CPU auf verbundene Beschleuniger auszuweiten.
Google zufolge unterstützt TPU 8tx das private Fine-Tuning, die Destillation und das Reinforcement Learning von Modellen, ohne dass sensible Daten zwischen separaten Clustern verschoben werden müssen. Das Boardfly-Netzwerk liefert laut Angaben bis zu halb so hohe Latenzen wie TPU 8t – bei einem laut Unternehmen minimalen Overhead durch die Schutzmechanismen des vertraulichen Computings.
Das System könnte für Finanzinstitute, Gesundheitsdienstleister und andere Organisationen interessant sein, die vertrauliche Informationen verarbeiten. Ein Cloudflare-KI-Datenleck im Oktober 2026 legte zwischengespeicherte Informationen aus früheren Anfragen in Antworten offen, die an andere Kunden ausgeliefert wurden. Der Vorfall veranschaulicht die Bedeutung der Speicherisolierung, allerdings gibt es keine Hinweise darauf, dass TPU 8tx ihn verhindert hätte.
Was eWeek herausgefunden hat: Mehr Hardwarekapazität garantiert keine bessere KI-Leistung in Unternehmen
Googles Spezifikationen zeigen zwei Ansätze für die KI-Infrastruktur von Unternehmen, doch keiner von beiden belegt, wie stark Unternehmen in der Produktion profitieren werden.
| TPU 8i Max | TPU 8tx | |
|---|---|---|
| Hauptzweck | Speicherintensive KI-Workloads | Vertrauliche KI-Verarbeitung |
| Hardwaredesign | Zwei TPU-8i-Chips in einem Package | TPU-8t-Silizium mit AMD-EPYC-Hosts |
| Wichtigste Verbesserung | 2× Rechenleistung, SRAM- und HBM-Bandbreite gegenüber TPU 8i | Hardwaregestützter Schutz für Daten bei der Verarbeitung |
| Anwendung im Unternehmen | Inferenz mit umfangreichem Kontext und KI-Agenten | Private Modellanpassung und sensible Workloads |
| Was noch nicht bewiesen ist | Leistungszuwächse und Kostenvorteile in der Produktion | Unabhängige Sicherheitsvalidierung und Eignung für Compliance-Anforderungen |
Quelle: Google Cloud und AMD, 9. November 2026. Die Leistungsspezifikationen stammen aus Herstellerangaben.
TPU 8i Max verdoppelt Rechenkapazität und Speicherbandbreite, doch bei Workloads, die durch Vernetzung, Speicher oder Software begrenzt sind, können die Leistungszuwächse geringer ausfallen. TPU 8tx ergänzt hardwaregestütztes vertrauliches Computing, beseitigt jedoch keine Schwachstellen auf Anwendungsebene und begründet keine regulatorische Compliance.
Unternehmen benötigen weiterhin Workload-spezifische Benchmarks und Preise, um die Wirtschaftlichkeit des TPU 8i Max zu beurteilen. Für TPU 8tx beschreibt AMD eine Hardwareverifizierung der Identität des Beschleunigers und der Sicherheitskonfiguration, doch Kunden müssen die Attestierungsnachweise und unabhängige Sicherheitstests bewerten.
Solange Preise, Verfügbarkeit und die Leistung in der Produktion nicht feststehen, bleiben die Vorteile der Systeme für Unternehmen über ihre Architekturspezifikationen hinaus unbewiesen.
Möchten Sie mehr über KI-Tipps, Tricks und Prompting-Techniken erfahren? Lassen Sie sich von uns How to Talk to AI kostenlos beibringen! Probieren Sie unseren sechminütigen Kurs an der The Neuron Academy aus, unserer praxisorientierten Lernplattform, die Berufstätigen helfen soll, KI selbstbewusster bei der Arbeit einzusetzen.
Lernen Sie einige einfache Methoden kennen, um bessere Prompts zu schreiben und nützlichere Ergebnisse von KI zu erhalten, oder stöbern Sie sieben Tage lang kostenlos in unserem anderen KI-Kurs. eWeek-Leser erhalten 7 Tage kostenlosen Zugang. Hier finden Sie alle Lektionen →