




Un processeur d’IA peut disposer d’une grande puissance de calcul tout en passant du temps à attendre les données. Le matériel dernier cri de Google s’attaque à ce goulet d’étranglement, mais aussi à une autre préoccupation des entreprises : protéger les informations sensibles pendant leur traitement par les modèles d’IA.
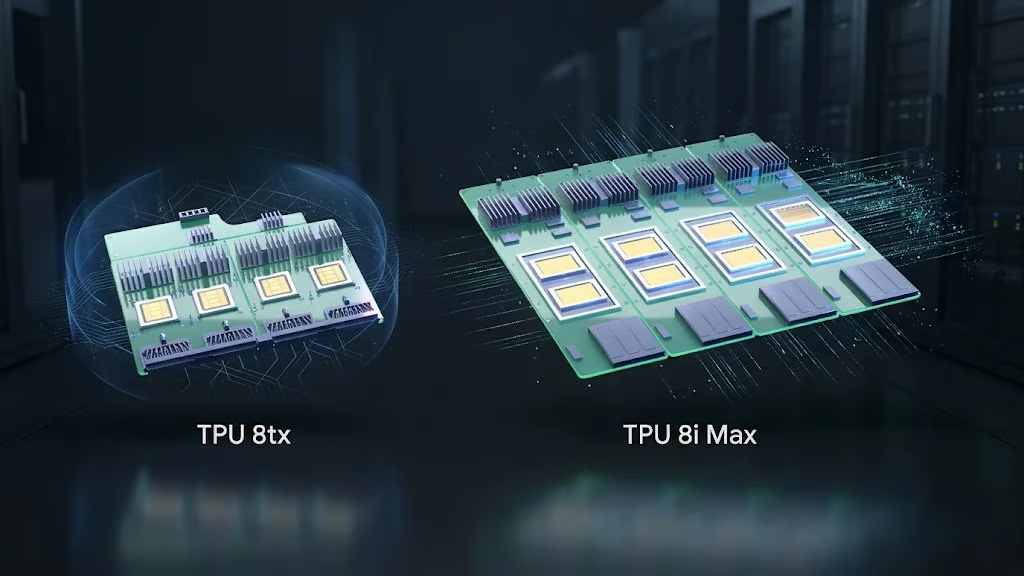
Google a annoncé deux nouveaux systèmes à base d’unités de traitement tensoriel (TPU) le 9 novembre : le TPU 8i Max, conçu pour les charges de travail d’IA gourmandes en mémoire, et le TPU 8tx, destiné au calcul confidentiel. Tous deux étoffent la gamme de TPU de huitième génération de Google, alors que les entreprises mettent en production des agents d’IA toujours plus complexes.
Les systèmes utilisent le silicium TPU existant plutôt que des architectures de puces entièrement nouvelles. L’annonce matérielle de Google aborde deux contraintes auxquelles sont confrontées les entreprises qui développent leurs déploiements d’IA et leur accompagnement technique : la bande passante mémoire et la protection des données propriétaires pendant leur traitement.
Une étude de 2024 sur le mur de la mémoire de l’IA a révélé que la puissance de calcul maximale des serveurs avait été multipliée environ par trois tous les deux ans, contre une progression de 1,6 fois pour la bande passante de la DRAM. Cet écart explique en partie pourquoi des processeurs plus rapides ne suffisent pas toujours à améliorer l’inférence de l’IA.
Le TPU 8i Max double la bande passante mémoire
Le TPU 8i Max associe deux puces TPU 8i dans un même boîtier. Google affirme qu’il double la capacité de calcul, la mémoire statique à accès aléatoire (SRAM) intégrée à la puce et la bande passante de la mémoire à large bande passante (HBM), par rapport au TPU 8i. Il intègre également deux fois plus de silicium dans la même empreinte de rack.
Le système vise les charges de travail nécessitant un contexte étendu, notamment les agents d’IA qui analysent de vastes dépôts logiciels ou des heures de vidéo. Une bande passante mémoire accrue peut réduire les délais de traitement, mais doubler les ressources matérielles ne garantit pas de doubler le débit applicatif.
Google a également présenté TPU Sync, une couche de gestion de l’état des modèles qui transfère le contexte d’IA mis en cache entre la mémoire de l’accélérateur, la mémoire de l’hôte et le stockage. Des tests internes ont montré des réductions supérieures à 90 % pour certaines opérations de transfert du cache. Ces résultats provenaient toutefois de l’architecture Ironwood précédente de Google, et non du TPU 8i Max.
Les performances réelles dépendront des besoins en mémoire, du réseau et du taux d’utilisation propres à chaque charge de travail. Les entreprises doivent mesurer ces facteurs parallèlement aux coûts d’exploitation des agents d’IA avant d’évaluer le retour sur investissement d’une capacité d’accélération supplémentaire.
Le TPU 8tx ajoute le calcul confidentiel
Le TPU 8tx s’attaque à la protection des données pendant le traitement de l’IA. Le calcul confidentiel s’appuie sur une isolation assurée par le matériel pour protéger les informations en cours d’utilisation, en complément du chiffrement des données au repos et en transit.
Le système associe du silicium TPU 8t à des processeurs AMD EPYC de cinquième génération. Dans son annonce du 9 novembre, AMD a expliqué comment sa technologie Secure Encrypted Virtualization contribue à étendre les protections du calcul confidentiel du processeur hôte aux accélérateurs connectés.
Google affirme que le TPU 8tx prend en charge l’affinage privé des modèles, la distillation et l’apprentissage par renforcement sans déplacer les données sensibles entre des clusters distincts. Selon les informations disponibles, son réseau Boardfly offre une latence jusqu’à deux fois inférieure à celle du TPU 8t, avec une surcharge minimale due aux protections du calcul confidentiel, d’après l’entreprise.
Le système pourrait séduire les établissements financiers, les prestataires de santé et les autres organisations qui traitent des informations confidentielles. Une fuite de données de Cloudflare AI survenue en octobre 2026 a exposé, dans des réponses envoyées à d’autres clients, des informations mises en cache provenant de requêtes antérieures. Cet incident illustre l’importance de l’isolation de la mémoire, même rien ne prouve que le TPU 8tx l’aurait empêché.
Ce qu’a constaté eWeek : une capacité matérielle accrue ne garantit pas de meilleures performances de l’IA en entreprise
Les caractéristiques présentées par Google révèlent deux approches de l’infrastructure d’IA d’entreprise, mais aucune ne permet d’établir les gains que les entreprises obtiendront en production.
| TPU 8i Max | TPU 8tx | |
|---|---|---|
| Objectif principal | Charges de travail d’IA gourmandes en mémoire | Traitement confidentiel de l’IA |
| Conception matérielle | Deux puces TPU 8i dans un même boîtier | Silicium TPU 8t avec des hôtes AMD EPYC |
| Amélioration clé | 2× plus de calcul, de SRAM et de bande passante HBM par rapport au TPU 8i | Protection des données en cours d’utilisation assurée par le matériel |
| Application en entreprise | Inférence sur de grands contextes et agents d’IA | Personnalisation privée des modèles et charges de travail sensibles |
| Ce qui reste à démontrer | Gains de performances et avantages économiques en production | Validation indépendante de la sécurité et adéquation aux exigences de conformité |
Source : Google Cloud et AMD, 9 novembre 2026. Les caractéristiques de performances sont celles communiquées par les fabricants.
Le TPU 8i Max double la capacité de calcul et la bande passante mémoire, mais les charges de travail limitées par le réseau, le stockage ou les logiciels pourraient enregistrer des gains de performances plus modestes. Le TPU 8tx ajoute un calcul confidentiel assuré par le matériel, sans éliminer les vulnérabilités au niveau des applications ni établir la conformité réglementaire.
Les acheteurs en entreprise ont encore besoin de benchmarks propres à leurs charges de travail et d’une tarification pour évaluer l’intérêt économique du TPU 8i Max. Pour le TPU 8tx, AMD décrit une vérification matérielle de l’identité de l’accélérateur et de sa configuration de sécurité, mais les clients doivent évaluer les preuves d’attestation et les tests de sécurité indépendants.
Tant que la tarification, la disponibilité et les performances en production ne seront pas établies, les avantages de ces systèmes pour les entreprises resteront à démontrer au-delà de leurs caractéristiques architecturales.
Vous voulez découvrir d’autres conseils, astuces et techniques de formulation de prompts pour l’IA ? Laissez-nous vous apprendre Comment parler à l’IA gratuitement ! Suivez notre cours de six minutes à The Neuron Academy, notre plateforme d’apprentissage pratique conçue pour aider les professionnels à utiliser l’IA avec plus d’assurance au travail.
Découvrez quelques méthodes simples pour rédiger de meilleurs prompts et obtenir des résultats plus utiles avec l’IA, ou consultez gratuitement pendant sept jours notre autre cours consacré à l’IA. Les lecteurs d’eWeek bénéficient de sept jours d’accès gratuit. Découvrez toutes les leçons ici →