
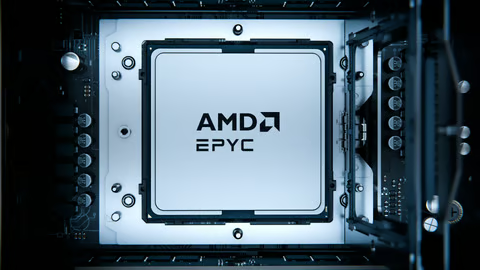


AMD affirme que son processeur serveur EPYC 9996 « Venice » offre un débit SPECrate 2026 Integer au niveau de la plateforme 2,24× supérieur à celui de Nvidia Vera, donnant un chiffre marquant à sa stratégie de promotion des processeurs x86 dans les infrastructures d’IA de nouvelle génération.
La comparaison ne mesure pas les processeurs avec un nombre de cœurs similaire. Chaque EPYC 9996 possède 256 cœurs et 512 threads, contre 88 cœurs et 176 threads pour Vera. Dans une comparaison distincte d’AMD utilisant une configuration Venice à 96 cœurs, l’avantage revendiqué tombe à environ 20 % par cœur.
La revendication de 2,24× d’AMD mesure le débit de la plateforme
AMD a publié ces chiffres le 18 septembre dans le cadre d’un argumentaire plus large sur les performances des processeurs EPYC 9006 de 6e génération pour des charges de travail d’entreprise, de cloud, d’IA et de calcul haute performance. Ses résultats de benchmark indiquent un score SPECrate 2026 Integer estimé de 2 070 pour un système EPYC 9996 à deux sockets et de 925 pour une plateforme Vera à deux sockets.
AMD décrit ces chiffres comme des estimations préliminaires des performances, fondées sur des projections d’ingénierie et susceptibles d’évoluer. Sa méthodologie actuelle indique GCC 15.2 pour les deux systèmes de la comparaison à 2,24×.
Venice équipera également le Helios rack-scale AI platform, aux côtés des accélérateurs Instinct et du réseau Pensando. Le Vera CPU de Nvidia possède 88 cœurs Olympus, 176 threads, jusqu’à 1,5 To de mémoire LPDDR5X et jusqu’à 1,2 To/s de bande passante mémoire. Des systèmes Vera Rubin sont déjà prévus pour des déploiements comprenant notamment des centres de données soutenus par OpenAI en Malaisie.
L’estimation d’AMD à nombre de cœurs plus comparable utilise une configuration EPYC de 6e génération à 96 cœurs. Elle obtient un score de 1 210, soit 6,3 par cœur, contre 925 et 5,3 par cœur pour Vera — soit environ un avantage de 1,2× par cœur.
AMD prévoit également un débit au niveau du rack 3,4× supérieur à celui d’une plateforme basée sur Vera dans le cadre d’une limite de puissance modélisée de 100 kilowatts. Le calcul couvre six charges de travail ; il ne s’agit pas d’un déploiement en rack mesuré en face à face.
Les règles de CPU 2026 de SPECautorisent les chiffres de performances estimés lorsqu’ils sont clairement identifiés comme tels. Les résultats SPEC publiés sont soumis à des exigences supplémentaires en matière de reproductibilité et de transparence.
Ce qu’a constaté eWeek : la densité de cœurs explique une grande partie de l’avance de 2,24× d’AMD
Les chiffres d’AMD montrent que la densité de cœurs explique une grande partie de l’avantage mis en avant. Un système EPYC 9996 à deux sockets compte 512 cœurs CPU, contre 176 dans un système Vera à deux sockets. L’estimation de débit de 2,24× ne signifie donc pas qu’un cœur Venice individuel est plus de deux fois plus rapide.
La comparaison plus proche d’AMD ramène l’avantage revendiqué à environ 20 % par cœur, en comparant Venice à 96 cœurs et Vera à 88 cœurs. Les grands nombres de cœurs deviennent un champ de bataille de plus en plus important pour les CPU serveur, le Xeon Diamond Rapids à 256 cœurs d’Intel visant lui aussi les charges de travail d’IA et de centres de données.
Une densité supérieure peut influer sur la consolidation des serveurs, l’utilisation des racks, les licences logicielles, les besoins en énergie et le placement des charges de travail. Le choix de la plateforme dépend toujours aussi de la bande passante mémoire, de la compatibilité x86 par rapport à Arm, de l’intégration CPU-GPU, des performances applicatives et du coût total de possession.
Les estimations d’AMD étayent l’argument en faveur de la densité de débit de Venice, mais des tests indépendants sur des systèmes de production restent nécessaires pour établir comment les deux plateformes se comparent dans les déploiements d’IA en entreprise.
En savoir plus : AMD explore une autre approche de l’infrastructure d’inférence avec AMD et Cerebras répartissent l’inférence IA entre Helios et des processeurs à l’échelle de la tranche afin de cibler la latence et l’efficacité de l’infrastructure.