






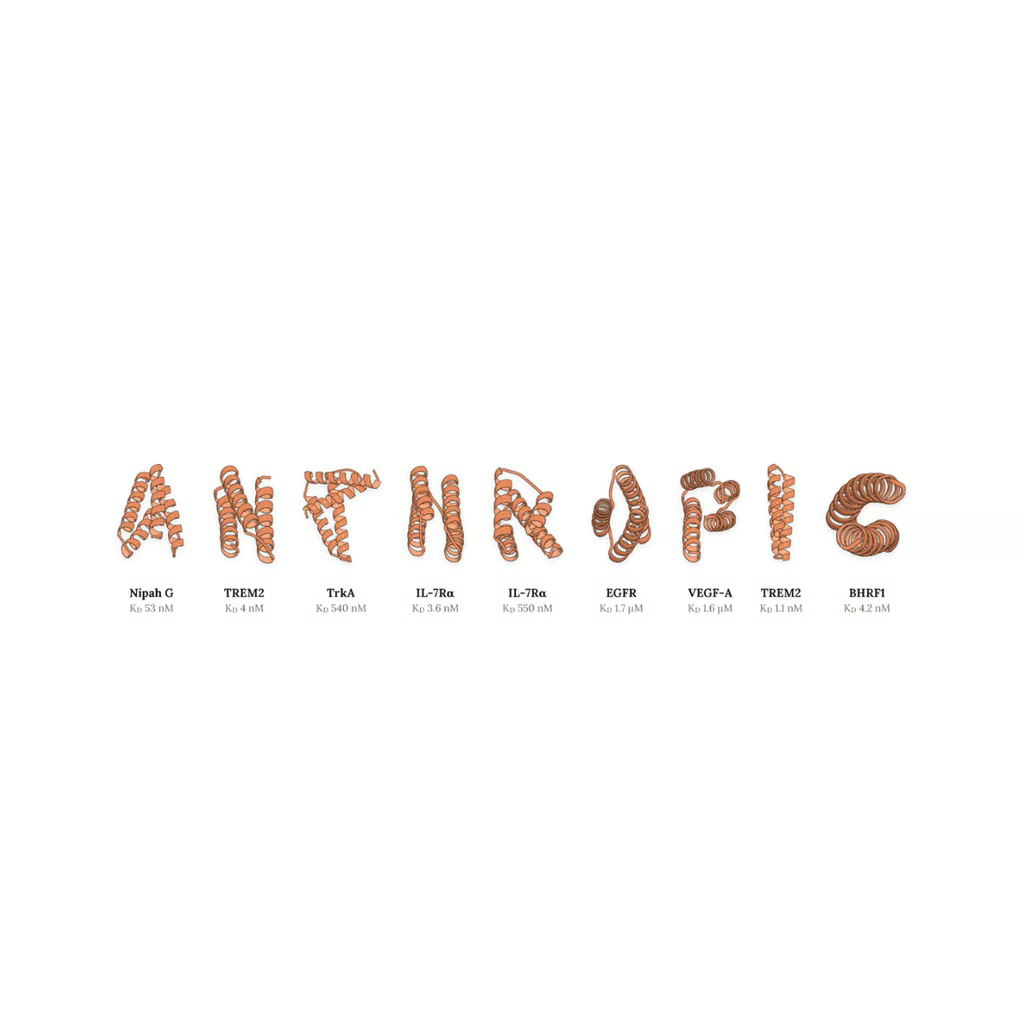


Claude geht über das Erklären biologischer Zusammenhänge hinaus und hilft nun dabei, Moleküle zu entwerfen, die im Labor tatsächlich funktionieren.
Anthropic veröffentlichte am Dienstag experimentelle Ergebnisse, denen zufolge seine Claude-Künstliche-Intelligenzmodelle autonom funktionale Proteinbinder entwarfen und komplexe analytische Chemie-Workflows innerhalb weniger Minuten ausführten. Die Ergebnisse deuten auf eine wachsende Rolle von Modellen mit allgemeinem Schlussfolgerungsvermögen in der biotechnologischen Forschung im Frühstadium hin.
In einer Kampagne mit mehreren Zielmolekülen sollten Claude Opus 4.8 und Mythos Preview de novo Protein-Minibinder erzeugen – kleine molekulare Strukturen, die sich an Zielproteine heften sollen. Für 15 biologische Zielmoleküle erzeugten die Modelle 1.320 Kandidatendesigns. Unabhängige Nasslabortests von Adaptyv Bio und Twist Bioscience bestätigten, dass 354 Designs erfolgreich an ihre Zielmoleküle banden – damit wurden 14 der 15 getesteten Ziele getroffen.
Je nach operativer Konfiguration erzielten die Modelle Trefferquoten zwischen 22,6 % und 35,1 % und lagen damit deutlich über der Erfolgsquote von 10 % bis 15 %, die für herkömmliche Branchenkampagnen typisch ist. Gegen RBX1, ein regulatorisches Proteinziel, Mythos Preview erzielte im Einzelzielmodus eine Trefferquote von 40 % und übertraf damit menschliche Teilnehmer eines früheren Wettbewerbs von Adaptyv Bio, die eine Erfolgsquote von 3,7 % verbuchten, so das Unternehmen.
Claude erzeugte außerdem kreuzreaktive Binder gegen TNFα, ein an der Entzündungsübertragung beteiligtes Protein, auf das Blockbuster-Therapien wie Humira abzielen. Opus 4.8 erzeugte 12 valide Designs, die an menschliche, Affen- und Mausvarianten von TNFα binden konnten.
In einem separaten Versuch zur Bewertung analytischer Chemieaufgaben testete Anthropic sein allgemein verfügbares Modell Claude Opus 5 mit Rohdaten aus Kernspinresonanzspektroskopie (NMR) und Flüssigchromatografie mit Massenspektrometrie (LC-MS).
Mit unformatierten Instrumentendateien aus einem Auftragslabor und einem kurzen Prompt ausgestattet, Claude interpretierte die Datensätze parallel in 23 beziehungsweise 19 Minuten. Das System ermittelte eine Reinheit der Verbindung von 96,4 %, was dem Laborergebnis von 96,33 % entsprach, und leitete korrekt ein nicht dokumentiertes Dateiformat des Anbieters her, während es sich selbst korrigierende Validierungsprüfungen ausführte.
Von spezialisierten Modellen zur agentischen Orchestrierung
Die Bedeutung dieser Versuche liegt in Claudes Fähigkeit, als autonomer Koordinator zu agieren und nicht als eigenständiger biologischer Rechner. Statt eine proprietäre Faltungs-Engine zu trainieren, stattete Anthropic Claude mit einem Protokoll-Prompt von ungefähr 16.000 Wörtern, Rechenleistung von bis zu 12.500 Nvidia-H100-GPU-Stunden und Zugriff auf etablierte Open-Source-Tools wie RFdiffusion, ProteinMPNN und ESMFold2 aus.
Claude wählte Bindungsstellen aus, rief Struktur-Generierungstools über 24 verschiedene Workflow-Kombinationen hinweg auf und bewertete Kandidaten, ohne dass während der Laufzeit ein Mensch steuernd eingriff. Dadurch verlagert sich der Engpass in der Computational Biology von der manuellen Orchestrierung von Skripten zum agentischen Aufgabenmanagement.
Engpässe und Leitplanken für die duale Nutzung
Trotz der Leistungssteigerungen stellt die rechnergestützte Erzeugung von Bindern lediglich die Anfangsphase der Arzneimittelentwicklung dar. Kandidatenmoleküle müssen jahrelange Nasslabortests, strukturelle Optimierung, Sicherheitsprofile und klinische Studien durchlaufen, bevor sie zu brauchbaren Therapeutika werden.
Die Modelle zeigten zudem Leistungsgrenzen: Claude konnte keine bestätigten Binder für das maltosebindende Protein (MBP) erzeugen, ein notorisch glattes Zielmolekül, und erzielte gegen das synthetische Protein BBF-14 nur schwache Affinitätswerte.
Der größere Test wird jedoch außerhalb von Benchmark-Kampagnen stattfinden. Claude könnte Tausende Möglichkeiten weitaus schneller als manuell arbeitende Forschende auf vielversprechende Kandidaten eingrenzen, doch die Validierung im Nasslabor bleibt die Trennlinie zwischen einem überzeugenden KI-Ergebnis und einer tragfähigen wissenschaftlichen Entdeckung.
Während Modelle mehr Teile dieses Forschungs-Workflows im Frühstadium übernehmen, müssen Labore nicht nur bestimmen, wie viel Autonomie sie ihnen zugestehen, sondern auch, an welchen Stellen menschliche Überprüfung und Biosicherheitskontrollen unverzichtbar bleiben müssen.
Weitere Nachrichten: DeepSeek V4-Pro fordert Claude Opus 5 bei Entwickler-Workloads heraus, bietet deutlich niedrigere API-Preise und breitere Kompatibilität, während das Modell von Anthropic bei komplexer Softwareentwicklung und langfristig laufenden KI-Agenten einen Vorsprung hat.