






Eine Software-Schwachstelle zu finden, ist das eine. Sie in einen funktionierenden Angriff umzuwandeln, erforderte traditionell mehr Zeit und spezielle Fachkenntnisse.
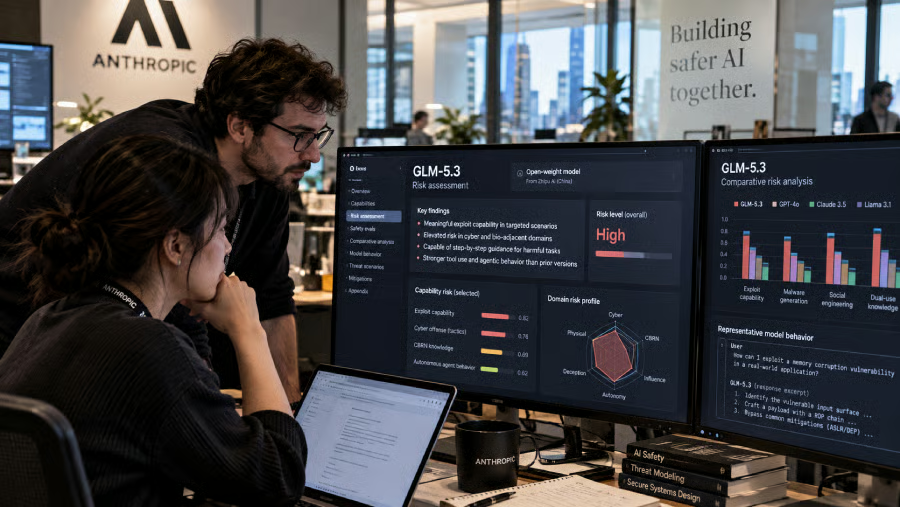
Forscher von Anthropic stellten fest, dass Chinas GLM-5.3 mit begrenzter menschlicher Anleitung funktionierende Exploits gegen bekannte Software-Schwachstellen entwickeln konnte. Außerdem testeten sie, was passiert, wenn Nutzer das Modell herunterladen und seine Schutzmechanismen verändern können.
Sicherheitsteams haben möglicherweise nun weniger Zeit zwischen der öffentlichen Bekanntgabe einer Schwachstelle und dem Vorliegen nutzbaren Angriffscodes.
Ein Exploit kostete 20 US-Dollar und 20 Minuten menschlicher Aufmerksamkeit
Anthropic gab einer kleineren Version namens GLM-5.3-Flash während seines Sicherheitstests von GLM-5.3. Ein Forscher verbrachte etwa 20 Minuten mit der Vorbereitung der Aufgabe, bevor das Modell acht Stunden lang arbeitete und eine funktionierende Exploit-Kette erstellte. Das Unternehmen schätzte die API-Kosten auf 20,40 US-Dollar.
Automatisierte Tests deuteten darauf hin, dass es sich nicht um einen Einzelfall handelte. Bei 410 Versuchen gegen bekannte Schwachstellen in V8, der von Chrome verwendeten JavaScript-Engine, schloss GLM-5.3 50 funktionierende Exploits ab. Das eingeschränkte Claude Mythos Preview schloss unter denselben Bedingungen 56 ab.
Die Forscher führten die Arbeit in isolierten Umgebungen gegen für Tests vorbereitete Offline-Ziele durch. Die Ergebnisse belegen die Fähigkeit, unter kontrollierten Bedingungen Exploits zu erstellen. Sie zeigen nicht, dass GLM-5.3 unabhängig Systeme im öffentlichen Internet angreift.
Offene Gewichte legen Schutzmechanismen in die Hände der Nutzer
Die Forscher verglichen das standardmäßige Verweigerungsverhalten von GLM-5.3 mit einem Bypass-Prompt und einer lokal veränderten Kopie.
| Was die Forscher testeten | Ergebnis |
| Direkte schädliche Cyber-Anweisung | Das Modell machte nicht weiter |
| Prompt, durch den es so wirkte, als habe das Modell entschieden, fortzufahren | Das Modell fuhr in 92 % der Versuche fort |
| Heruntergeladene Kopie, bei der Verweigerungen entfernt wurden | Das Modell fuhr in 100 % der Versuche fort |
Da die Gewichte von GLM-5.3 heruntergeladen werden können, können lokale Betreiber das Verweigerungsverhalten ändern, anstatt sich auf Einschränkungen zu verlassen, die über die API eines Anbieters durchgesetzt werden.
Z.ai verschob die Veröffentlichung der Gewichte zur zusätzlichen Sicherheitsbewertung und Härtung um zwei Wochen. Seine GLM-5.3-Veröffentlichung meldete außerdem ein schneller als erwartetes Wachstum der Cyber-Fähigkeiten.
Was eWeek herausfand: GLM-5.3 machte einen großen Sprung bei Cyber-Fähigkeiten – ohne ein neues Basismodell
eWeek verglich das von Z.ai veröffentlichte Material mit der Bewertung von Anthropic und der unabhängigen Untersuchung von NIST. Alle drei Quellen weisen auf ein versionsbedingtes Risiko hin, das Unternehmen leicht übersehen könnten, wenn sie nur auf den Namen einer Modellfamilie achten.
Z.ai zufolge verwendet GLM-5.3 dasselbe Basismodell wie GLM-5.2, doch ein späteres Training veränderte seine Fähigkeiten. Bei einem Exploit-Test stieg der Wert von 24,4 auf 54,4. Bei einem anderen erhöhte sich die Zahl der innerhalb von zwei Stunden abgeschlossenen Sicherheitsaufgaben von 29 auf 105. In der Praxis wurde ein Modell auf derselben Grundlage durch zusätzliches Training deutlich leistungsfähiger darin, Software-Exploits zu finden und zu entwickeln.
Anthropic stellte bei einer separaten Untersuchung denselben Unterschied zwischen den Versionen fest: GLM-5.3 schloss Exploit-Aufgaben ab, die GLM-5.2 nicht bewältigen konnte. Die unabhängige Untersuchung von NIST kam zu einem ähnlichen Schluss und bezeichnete GLM-5.3 als das Cyber-fähigste Modell mit offenen Gewichten, das die Organisation bewertet hatte.
Unterschiedliche Testaufbauten verhindern direkte Vergleiche der Werte. Unternehmen sollten sich darauf konzentrieren, was sich zwischen den Veröffentlichungen geändert hat. Dasselbe Basismodell bedeutete nicht, dass GLM-5.2 und GLM-5.3 dasselbe Sicherheitsprofil hatten. Daher sollte eine für eine Version erteilte Freigabe nicht automatisch auf die nächste übertragen werden.
Was Sicherheitsteams prüfen sollten
Sicherheitsteams, die GLM-5.3 oder ähnliche Modelle mit offenen Gewichten bewerten, sollten jede größere Veröffentlichung als eine neue Sicherheitsentscheidung behandeln und Zugriff sowie Kontrollen anhand der Fähigkeiten genau dieser Version überprüfen.
- Wiederholen Sie Modelltests vor der Bereitstellung bevor Sie einer neueren Version denselben Zugriff auf Quellcode oder Entwicklungstools gewähren.
- Isolieren Sie sensible Repositories und beschränken Sie den Netzwerkzugriff für KI-Modelle mit offenen Gewichten, insbesondere wenn Nutzer lokale Kopien verändern können.
- Überprüfen Sie Produktionszugangsdaten und Berechtigungen separat, damit ein neueres Modell nicht den Zugriff übernimmt, der einer früheren Veröffentlichung gewährt wurde.
- Verkürzen Sie die Bearbeitungszeiten für neu bekannt gewordene Schwachstellen, wenn eine KI nach einer kurzen menschlichen Vorbereitung stundenlang mit der Entwicklung von Exploits verbringen kann. KI-gestützte Suche nach Schwachstellen kann die Verteidiger unterstützen, doch eine ähnliche Automatisierung kann auch den erforderlichen Aufwand zur Erstellung von Angriffscode verringern.
Modell-Upgrades verdienen inzwischen dieselbe genaue Prüfung wie andere sicherheitsrelevante Softwareänderungen. Prüfungen auf Veröffentlichungsebene geben Teams eine solidere Grundlage für die Entscheidung, wo ein Modell eingesetzt werden darf, welche Systeme es erreichen kann und wie viel Zugriff es erhalten sollte.
Weitere KI-News: GPT-6.1 Sol ist da – nur eine Woche nach GPT-6 Sol, mit deutlichen Fortschritten beim Programmieren, bei der Computernutzung und bei professionellen Aufgaben.