




Forschende waren traditionell auf gemeinsam genutzte GPU-Cluster und Supercomputer angewiesen, um rechenintensive KI- und wissenschaftliche Workloads auszuführen. Nvidia will mit einem neuen DGX-Spark-Cluster aus vier Systemen einen Teil dieser Rechenleistung näher an einzelne Forschungsteams bringen.
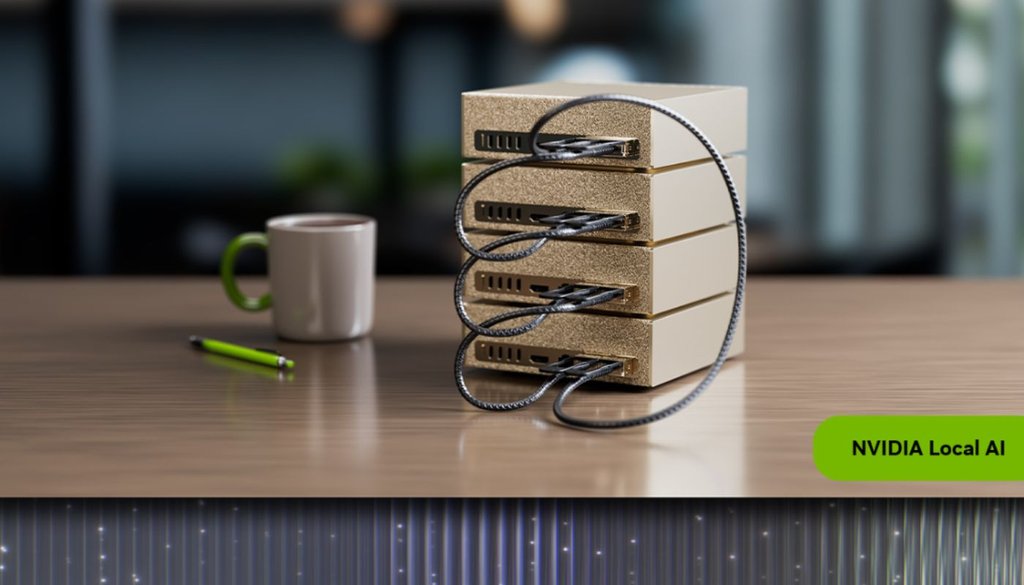
Auf der Veranstaltung SC26 in Chicago kündigte Nvidia am 16. Nov. das DGX Spark HPC Developer Kit an, um Supercomputing lokal an die Schreibtische von Forschenden zu bringen. Das neue Produkt umfasst vier DGX-Spark-Systeme, insgesamt 512 GB Arbeitsspeicher, 16 TB NVMe-Speicher und ConnectX-7-Netzwerktechnik in der HPC-Cluster-Konfiguration. Das Installationshandbuch für das Nvidia HPC SDK wird jedoch erst später verfügbar sein.
Nvidia zufolge kann dieses neue System ein KI-Modell mit bis zu 700 Milliarden Parametern ausführen. Zum Vergleich: Ein DGX-Spark-System mit 128 GB RAM kann nur ein Modell mit bis zu 200 Milliarden Parametern aufnehmen.
Durch die Bündelung von vier DGX-Spark-Systemen kann Nvidia eine lokale KI-Plattform bereitstellen, für die Forschende normalerweise einen gemeinsam genutzten GPU-Cluster verwenden müssten.
Die neue DGX-Plattform ist über den Nvidia Marketplace und OEM-Partner wie Acer, Dell und Lenovo erhältlich.
Was Forschende mit dem DGX Spark HPC Developer Kit tun können
Nvidia entwickelt DGX Spark weiter – von der eigenständigen KI-Berechnung auf dem Desktop hin zur Entwicklung von HPC-Anwendungen auf mehreren Knoten. Mit dieser neuen HPC-Konfiguration können Forschende:
- Wissenschaftliche Anwendungen entwickeln und testen: Unterstützung für Anwendungen wie LAMMPS, NAMD, GROMACS, OpenFOAM und WRF.
- Mit größeren KI-Modellen experimentieren: Modelle auf die vier Systeme verteilen
- Vertraute HPC-Entwicklungswerkzeuge verwenden: C-, C++- und Fortran-Compiler sowie GPU-beschleunigte Bibliotheken verwenden.
Nach den Experimenten auf ihren lokalen DGX-Systemen können Forschende ihre Workloads bei Bedarf auf leistungsfähigere Supercomputer verlagern.
Was eWEEK herausgefunden hat: Desktop-HPC muss seinen Nutzen im großen Maßstab noch unter Beweis stellen
Nvidia macht die HPC-Entwicklung zugänglicher, aber ein Desktop-Cluster mit vier Knoten ist kein Ersatz für eine umfangreiche Supercomputing-Infrastruktur. Sein Nutzen hängt davon ab, wie effektiv Forschende damit Workloads entwickeln, testen und optimieren können, bevor sie diese in Produktionsumgebungen überführen.
Forschende müssen zwei zentrale Fragen beantworten, bevor sie entscheiden können, ob die Einführung der DGX-Systeme einen größeren Nutzen bietet als ihr bisheriger Workflow:
- Leistung: Unterstützen die kombinierte Speicherkapazität und Rechenleistung die Workloads, die Forschende lokal ausführen möchten, ausreichend? Möglicherweise wäre es besser, wenn die Forschenden direkt einen Supercomputer nutzten.
- Skalierbarkeit: Können auf diesem Cluster entwickelte Anwendungen auf größere GPU-Cluster und Supercomputer übertragen werden? Wenn die größere HPC-Plattform eine andere Technologie wie Tensor Processing Units (TPUs) verwendet, kann dies die spätere Skalierung der Anwendung für die Forschenden erschweren.
Ein Desktop-Cluster könnte die Zeit bis zur Behebung eines Simulationsproblems verkürzen, selbst wenn die Simulation dort an sich langsamer läuft.
Für Teams, die Eingaben wiederholt ändern oder das Zusammenspiel der Knoten beim Datenaustausch debuggen, ist der aussagekräftige Vergleich die Zeit vom Bearbeiten des Codes bis zum Erhalt eines verwertbaren Ergebnisses. Dazu zählt auch die Zeit, die ein Job mit dem Warten auf einen gemeinsam genutzten Cluster verbringt.
Vor dem Kauf könnte ein Labor einen repräsentativen Workload über beide Workflows laufen lassen. Das Team sollte erfassen, wie viele Testzyklen es an einem Tag abschließt, und anschließend den überarbeiteten Workload auf dem vorgesehenen Produktionssystem ausführen, um Ergebnisse und Skalierung zu überprüfen. So ließe sich feststellen, ob das Desktop-Kit den Forschenden bei regelmäßig anfallenden Arbeiten Zeit spart.
Was das für Unternehmen bedeutet
Forschungseinrichtungen und Unternehmen können mit KI- und HPC-Workloads auf mehreren Knoten experimentieren, ohne sofort umfangreiche Infrastruktur beschaffen zu müssen.
Nvidia zufolge unterstützt die DGX-Plattform offene Modelle wie Nemotron 3.5 und Deepseek 4.1. Forschende haben daher die Möglichkeit, die Eignung von Workloads zu testen, ohne die Kosten proprietärer Modelle tragen zu müssen. Der lokale Betrieb offener Modelle verursacht jedoch weiterhin Kosten für Hardware, Energie und Infrastruktur.
Unternehmen können das Kit außerdem nutzen, um den praktischen Nutzen einer Desktop-HPC-Infrastruktur zu bewerten, bevor sie ihre Bereitstellungen ausweiten. Forschungseinrichtungen können beispielsweise prüfen, ob Rechenleistung, Speicherkapazität und Netzwerkfunktionen den Anforderungen ihrer Forschenden entsprechen.
Neben Einsparungen bei der Infrastruktur senkt ein lokaler Cluster die Hürde für die Schulung von Mitarbeitenden im Bereich des verteilten Rechnens. Nachwuchsingenieure und Fachwissenschaftler können auf dedizierter Hardware Message-Passing-Schnittstellen, das Debugging auf mehreren Knoten und die parallele Optimierung üben, ohne gemeinsam genutzte Produktionsumgebungen zu gefährden.
Auch wenn Unternehmen die anfänglichen Ausgaben für Hardware, Strom und Kühlung berücksichtigen müssen, verlagert ein Desktop-Cluster das Experimentieren vom unvorhersehbaren Cloud-Verbrauch hin zu kontrollierbaren Investitionskosten. Dadurch erhalten IT-Verantwortliche konkrete Nutzungskennzahlen und Kostenbaselines, bevor sie größere Bereitstellungen auf Rack-Ebene genehmigen.
Weitere Meldungen: Apples macOS 27.3-Beta ermöglicht es Nutzern, einige Apps auf bestimmte geschützte Ordner zu beschränken oder auszuwählen, welche anderen Apps sie steuern dürfen.