




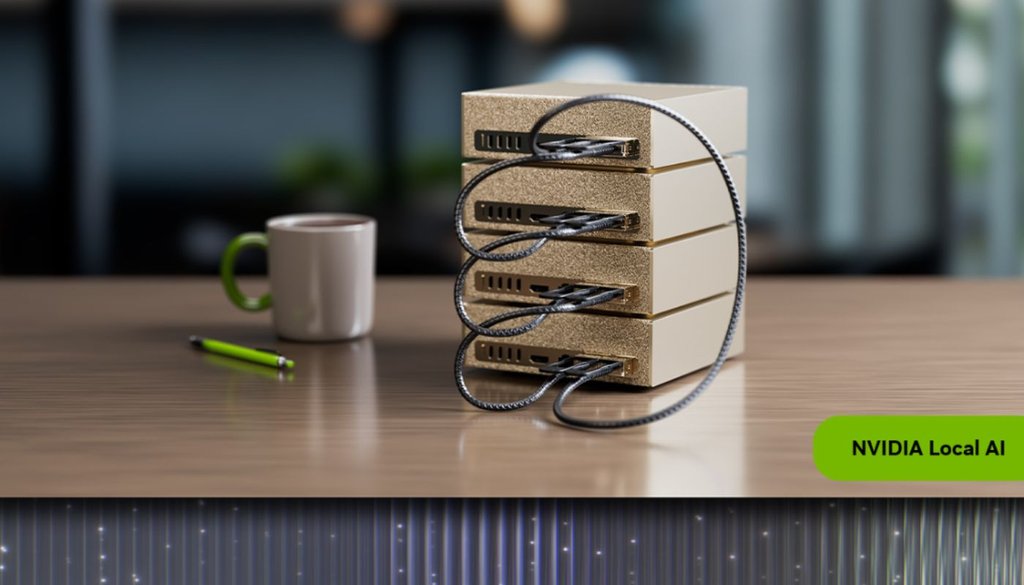
これまで研究者は、計算負荷の高いAIや科学分野のワークロードを実行するため、共有GPUクラスターやスーパーコンピューターに頼るのが一般的だった。Nvidiaは、4システム構成の新たなDGX Sparkクラスターによって、こうしたコンピューティング能力の一部を個々の研究チームの身近に届けようとしている。
Nvidiaは11月16日、シカゴで開催されたSC26で、研究者のデスクにローカルスーパーコンピューティングをもたらすDGX Spark HPC Developer Kitを発表した。新製品には、4台のDGX Sparkシステム、合計512GBのメモリー、16TBのNVMeストレージ、HPCクラスター構成のConnectX-7ネットワークが含まれる。ただし、Nvidia HPC SDKのインストール手順書は後日提供される。
Nvidiaによると、この新システムは最大7000億パラメーターのAIモデルを実行できる。比較として、128GBのRAMを搭載するDGX Spark 1台で対応できるのは、最大2000億パラメーターのモデルにすぎない。
4台のDGX Sparkシステムをクラスター化することで、Nvidiaは、通常なら研究者が共有GPUクラスターを利用しなければならないようなローカルAIプラットフォームを実現できる。
新しいDGXプラットフォームは、Nvidia MarketplaceおよびAcer、Dell、LenovoなどのOEMパートナーを通じて購入できる。
研究者はDGX Spark HPC Developer Kitで何ができるか
NvidiaはDGX Sparkの機能を拡張し、単体のデスクトップAIコンピューティングからマルチノードHPC開発へと領域を広げている。この新たなHPC構成では、研究者は次のことができる。
- 科学アプリケーションを開発・テストする:LAMMPS、NAMD、GROMACS、OpenFOAM、WRFなどのアプリケーションをサポートする。
- より大規模なAIモデルを試す:4台のシステムにモデルを分散する
- 使い慣れたHPC開発ツールを使用する:C、C++、Fortranコンパイラーや、GPUアクセラレーション対応ライブラリーを使用する。
研究者はローカルのDGXシステムで試行した後、必要に応じてワークロードをより強力なスーパーコンピューターへ移行できる。
eWEEKの見解:デスクトップHPCは依然として大規模環境での価値を証明する必要がある
NvidiaはHPC開発をより身近なものにしているが、4ノードのデスクトップクラスターは大規模なスーパーコンピューティングインフラに代わるものではない。その価値は、本番環境へ移行する前に、研究者がどれだけ効果的にワークロードを開発、テスト、最適化できるかにかかっている。
研究者は、DGXシステムの導入が現在のワークフローを上回る価値をもたらすかどうかを判断する前に、2つの重要な問いに答える必要がある。
- 性能:統合されたメモリー容量と演算能力は、研究者がローカルで実行したいワークロードを十分にサポートできるか。研究者がスーパーコンピューターを直接利用したほうがよい可能性もある。
- スケーラビリティ:このクラスターで開発したアプリケーションを、より大規模なGPUクラスターやスーパーコンピューターへ移行できるか。大規模なHPCプラットフォームがテンソルプロセッシングユニット(TPU)のような異なるテクノロジーを使用している場合、後からアプリケーションをスケールさせることが研究者にとって難しくなる可能性がある。
デスクトップクラスターではシミュレーション自体の実行速度が遅くても、シミュレーションの問題を修正するまでの時間を短縮できる可能性がある。
入力を繰り返し変更したり、ノード間のデータ交換をデバッグしたりするチームにとって、意味のある比較対象は、コードを編集してから、行動につなげられる結果を得るまでの時間だ。これには、ジョブが共有クラスターで待機する時間も含まれる。
購入前に、研究室は代表的なワークロードを2つのワークフローで実行してみるとよい。チームが1日に完了できるテストサイクル数を記録し、その後、改訂したワークロードを想定している本番システムで実行して、結果とスケーリングを確認する。そうすれば、デスクトップキットが日常的な作業で研究者の時間を節約できるかどうかが分かる。
企業にとっての意味
研究機関や企業は、大規模なインフラをすぐに調達することなく、マルチノードのAIおよびHPCワークロードを試行できる。
Nvidiaによると、同社のDGXプラットフォームはNemotron 3.5やDeepseek 4.1などのオープンモデルをサポートしている。そのため研究者は、独自モデルに伴う費用を負担せずに、ワークロードへの適合性をテストできる。ただし、オープンモデルをローカルで実行する場合でも、ハードウェア、電力、インフラのコストは発生する。
企業はこのキットを使って、導入範囲を拡大する前に、デスクトップHPCインフラの実用的な価値を評価することもできる。例えば研究機関は、演算能力、メモリー、ネットワーク機能が研究者の要件を満たしているかを評価できる。
インフラのコスト削減に加えて、ローカライズされたクラスターは、分散コンピューティングのスタッフ研修へのハードルを下げる。若手エンジニアや分野研究者は、共有されている本番環境を中断するリスクなしに、専用ハードウェア上でメッセージパッシングインターフェース、マルチノードのデバッグ、並列最適化を実践できる。
組織は初期のハードウェア、電力、冷却費を考慮する必要があるものの、デスクトップクラスターによって、予測が難しいクラウド利用から、管理可能な資本的支出へと実験の形を変えられる。これによりITリーダーは、より大規模なラックスケール導入を承認する前に、具体的な利用率の指標とコストの基準値を得られる。
その他のニュース:Apple’s macOS 27.3 betaでは、ユーザーは一部のアプリを特定の保護フォルダーに限定したり、制御を許可する他のアプリを選択したりできる