








Forscher der Unit 42 von Palo Alto Networks haben kürzlich zwei Sicherheitslücken in Googles Plattform Vertex AI entdeckt, durch die sensible Modelle für maschinelles Lernen (ML) bösartigen Angriffen ausgesetzt gewesen sein könnten. Angreifer hätten diese Sicherheitslücken ausnutzen können, um Berechtigungen zu missbrauchen und sich unbefugten Zugriff auf proprietäre Modelle und kritische Daten in den Entwicklungsumgebungen der Nutzer zu verschaffen.
Die erste Sicherheitslücke nutzte Berechtigungen für benutzerdefinierte Jobs aus innerhalb von Vertex AI Pipelines. Indem sie bösartigen Code in benutzerdefinierte Jobs einschleusten, konnten Angreifer ihre Rechte ausweiten und sich unbefugten Zugriff auf sensible Daten in Storage-Buckets und BigQuery-Datasets verschaffen. Diese Schwachstelle ermöglichte es Angreifern, Service-Agents zu manipulieren, damit diese nicht autorisierte Aktionen ausführten, etwa Daten außerhalb ihres vorgesehenen Zuständigkeitsbereichs aufzulisten, zu lesen und zu exportieren.
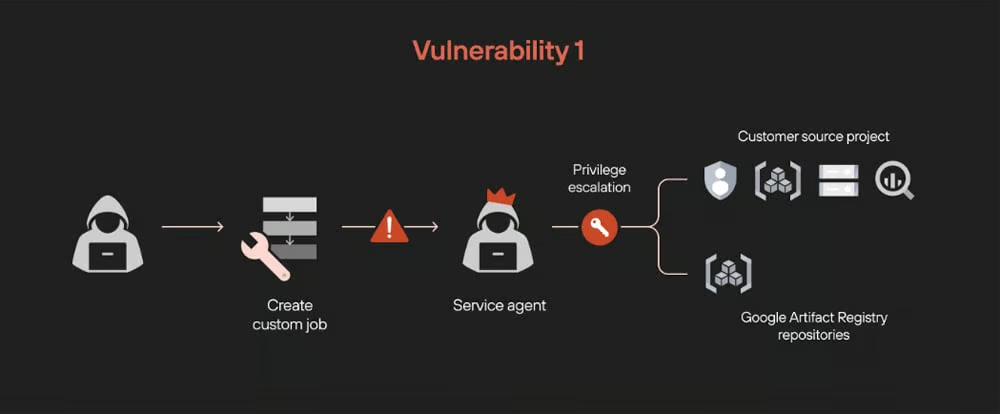
Eine Darstellung der ersten Sicherheitslücke. Bild: Unit42
Die zweite Sicherheitslücke stellte eine noch größere Bedrohung dar. Durch die Bereitstellung eines „vergifteten“ Modells in einer Vertex-AI-Umgebung konnten Angreifer sämtliche Modelle für maschinelles Lernen und feinabgestimmte LLMs innerhalb eines Projekts exfiltrieren. Dazu gehörten auch sensible Fine-Tuning-Adapter – kritische Komponenten, die proprietäre Informationen enthalten. Sobald das bösartige Modell aktiv war, fungierte es als Einfallstor, über das Angreifer auf proprietäre Modelldaten zugreifen und diese stehlen konnten.
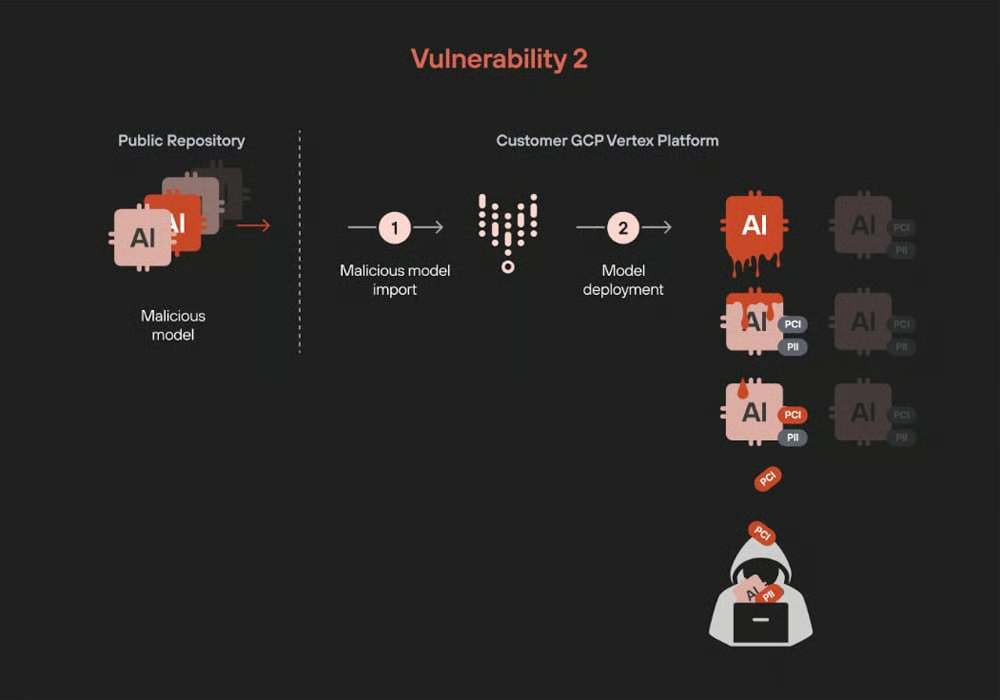
Eine Darstellung der zweiten Sicherheitslücke. Bild: Unit42
Googles Reaktion und Gegenmaßnahmen
Palo Alto Networks teilte die Erkenntnisse mit Google und veranlasste damit ein schnelles Vorgehen. Google hat Patches implementiert, um die identifizierten Sicherheitslücken in Vertex AI zu beheben und die Risiken einer Rechteausweitung und Modell-Exfiltration zu mindern. Obwohl diese Probleme behoben wurden, unterstreicht die Untersuchung die Notwendigkeit, dass Unternehmen beim Umgang mit sensiblen Daten aus dem Bereich der Künstlichen Intelligenz und des maschinellen Lernens wachsam bleiben.
Nach Ansicht des Forschungsteams müssen Unternehmen „strenge Kontrollen für die Bereitstellung von Modellen“ einführen, um sich vor solchen Risiken zu schützen. Die Forscher empfahlen, Entwicklungs- oder Testumgebungen von Produktionssystemen zu trennen, um eine klare Abgrenzung zu gewährleisten. So können Unternehmen das Risiko verringern, dass nicht geprüfte Modelle oder Code unbeabsichtigt Live-Systeme beeinträchtigen.
Die Unit42 von Palo Alto empfiehlt außerdem, dass nur unverzichtbares Personal Zugriff auf diese kritischen Funktionen erhält. Dadurch sinkt die Wahrscheinlichkeit nicht autorisierter Aktionen, die sensible Daten gefährden könnten. Unabhängig davon, ob sie aus internen Teams oder Repositories von Drittanbietern stammen: Alle Modelle müssen strengen Prüfungen unterzogen werden, um sicherzustellen, dass sie frei von bösartigem Code und Sicherheitslücken sind.
Erfahren Sie mehr darüber, wie generative KI in der Cybersicherheit eingesetzt werden kann.