








Des chercheurs de l’Unit 42 de Palo Alto Networks ont récemment découvert deux vulnérabilités de sécurité dans la plateforme Vertex AI de Google, qui pourraient avoir exposé des modèles sensibles d’apprentissage automatique (ML) à des attaques malveillantes. Des acteurs malveillants auraient pu exploiter ces vulnérabilités pour tirer parti des autorisations et obtenir un accès non autorisé à des modèles propriétaires ainsi qu’à des données critiques dans les environnements de développement des utilisateurs.
La première vulnérabilité exploitait les autorisations des tâches personnalisées dans Vertex AI Pipelines. En injectant du code malveillant dans des tâches personnalisées, des acteurs malveillants pouvaient élever leurs privilèges et obtenir un accès non autorisé à des données sensibles réparties entre des buckets de stockage et des ensembles de données BigQuery. Cette faille permettait aux attaquants de manipuler des agents de service afin qu’ils exécutent des actions non autorisées, comme répertorier, lire et exporter des données au-delà de leur périmètre prévu.
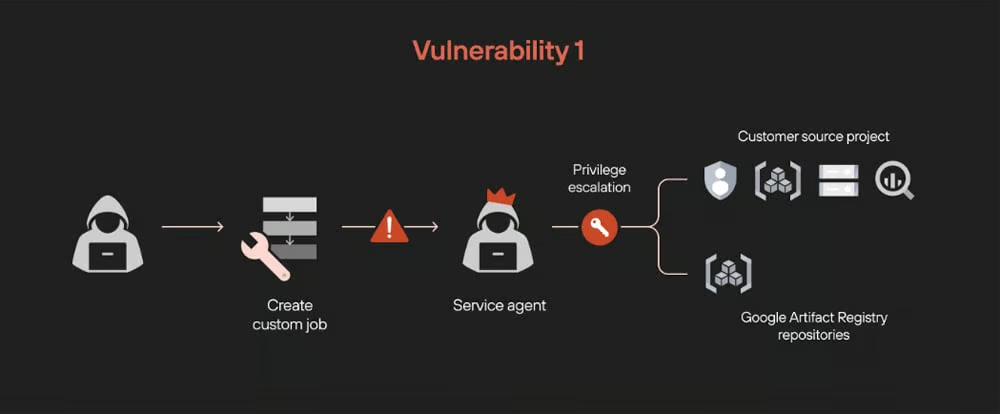
Schéma illustrant la première vulnérabilité. Image : Unit42
La deuxième vulnérabilité représentait une menace encore plus importante. En déployant un modèle « empoisonné » dans un environnement Vertex AI, les attaquants pouvaient exfiltrer tous les modèles d’apprentissage automatique et les LLM affiné au sein d’un projet. Cela comprenait des adaptateurs d’affinage sensibles, des composants critiques contenant des informations propriétaires. Une fois activé, le modèle malveillant servait de passerelle aux acteurs malveillants pour accéder aux données des modèles propriétaires et les dérober.
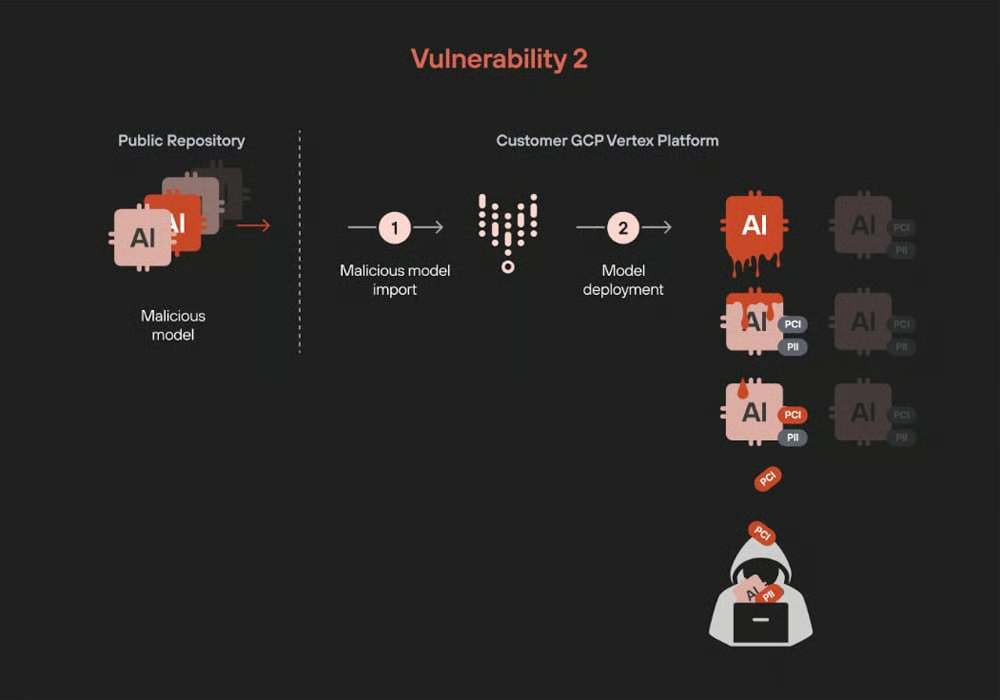
Schéma illustrant la deuxième vulnérabilité. Image : Unit42
Réponse et correctifs de Google
Palo Alto Networks a communiqué ses conclusions à Google, ce qui a incité l’entreprise à agir rapidement. Google a déployé des correctifs pour résoudre les vulnérabilités identifiées dans Vertex AI et atténuer les risques d’élévation de privilèges et d’exfiltration de modèles. Bien que ces problèmes aient été résolus, l’étude souligne la nécessité, pour les organisations, de rester vigilantes lors du traitement de données sensibles liées à l’intelligence artificielle et au ML.
Selon l’équipe de recherche, les organisations doivent mettre en place des « contrôles stricts du déploiement des modèles » pour se protéger contre ce type de risques. Elle recommande de séparer les environnements de développement ou de test des systèmes de production afin de maintenir une distinction claire et de permettre aux entreprises de réduire le risque que des modèles ou du code non vérifiés affectent involontairement les systèmes en production.
L’Unit42 de Palo Alto suggère également que seul le personnel indispensable ait accès à ces fonctions critiques. Cela réduit les risques d’actions non autorisées susceptibles de compromettre des données sensibles. Qu’ils proviennent d’équipes internes ou de référentiels tiers, tous les modèles doivent faire l’objet de contrôles rigoureux afin de vérifier qu’ils sont exempts de code malveillant ou de vulnérabilités.
Pour en savoir plus sur la manière dont l’IA générative peut être utilisée en cybersécurité.