




Alibabaの最新AIモデルはトークン当たりの料金が安くなったが、アップグレードしたからといって、あらゆるタスクで結果が向上するとは限らない。
11月16日にAlibabaが発表したQwen4-Maxは、同社の最新フラッグシップAIモデルだ。API料金が引き下げられ、推論とコーディングの改善が報告されている。開発者や企業は、業務用ソフトウェアを使う複雑な作業に利用できる。
Alibabaによると、今回の強化によって作業はより速く、低コストになる。独立した評価も、新システムが従来バージョンや競合AIモデルと比べてどのように機能するかを検証する手段となる。
業界をまたいだ作業に対応
Qwen4-Maxはテキスト、画像、動画を処理でき、100万トークンのコンテキストウィンドウによって、長大な文書や大量の情報を扱える。QwenCloudのドキュメントによると、Qwen Live Deliveryプラグインを使えば AIエージェントが利用可能な初版を作成し、ユーザーが進捗を確認して変更を依頼すると、それに応じて更新できる。
によると Alibaba、このモデルは業務用ソフトウェアを操作し、複数の手順からなる作業を実行できる。同社のデモでは、さまざまな業界での作業例が複数示された。
クリエイティブ制作
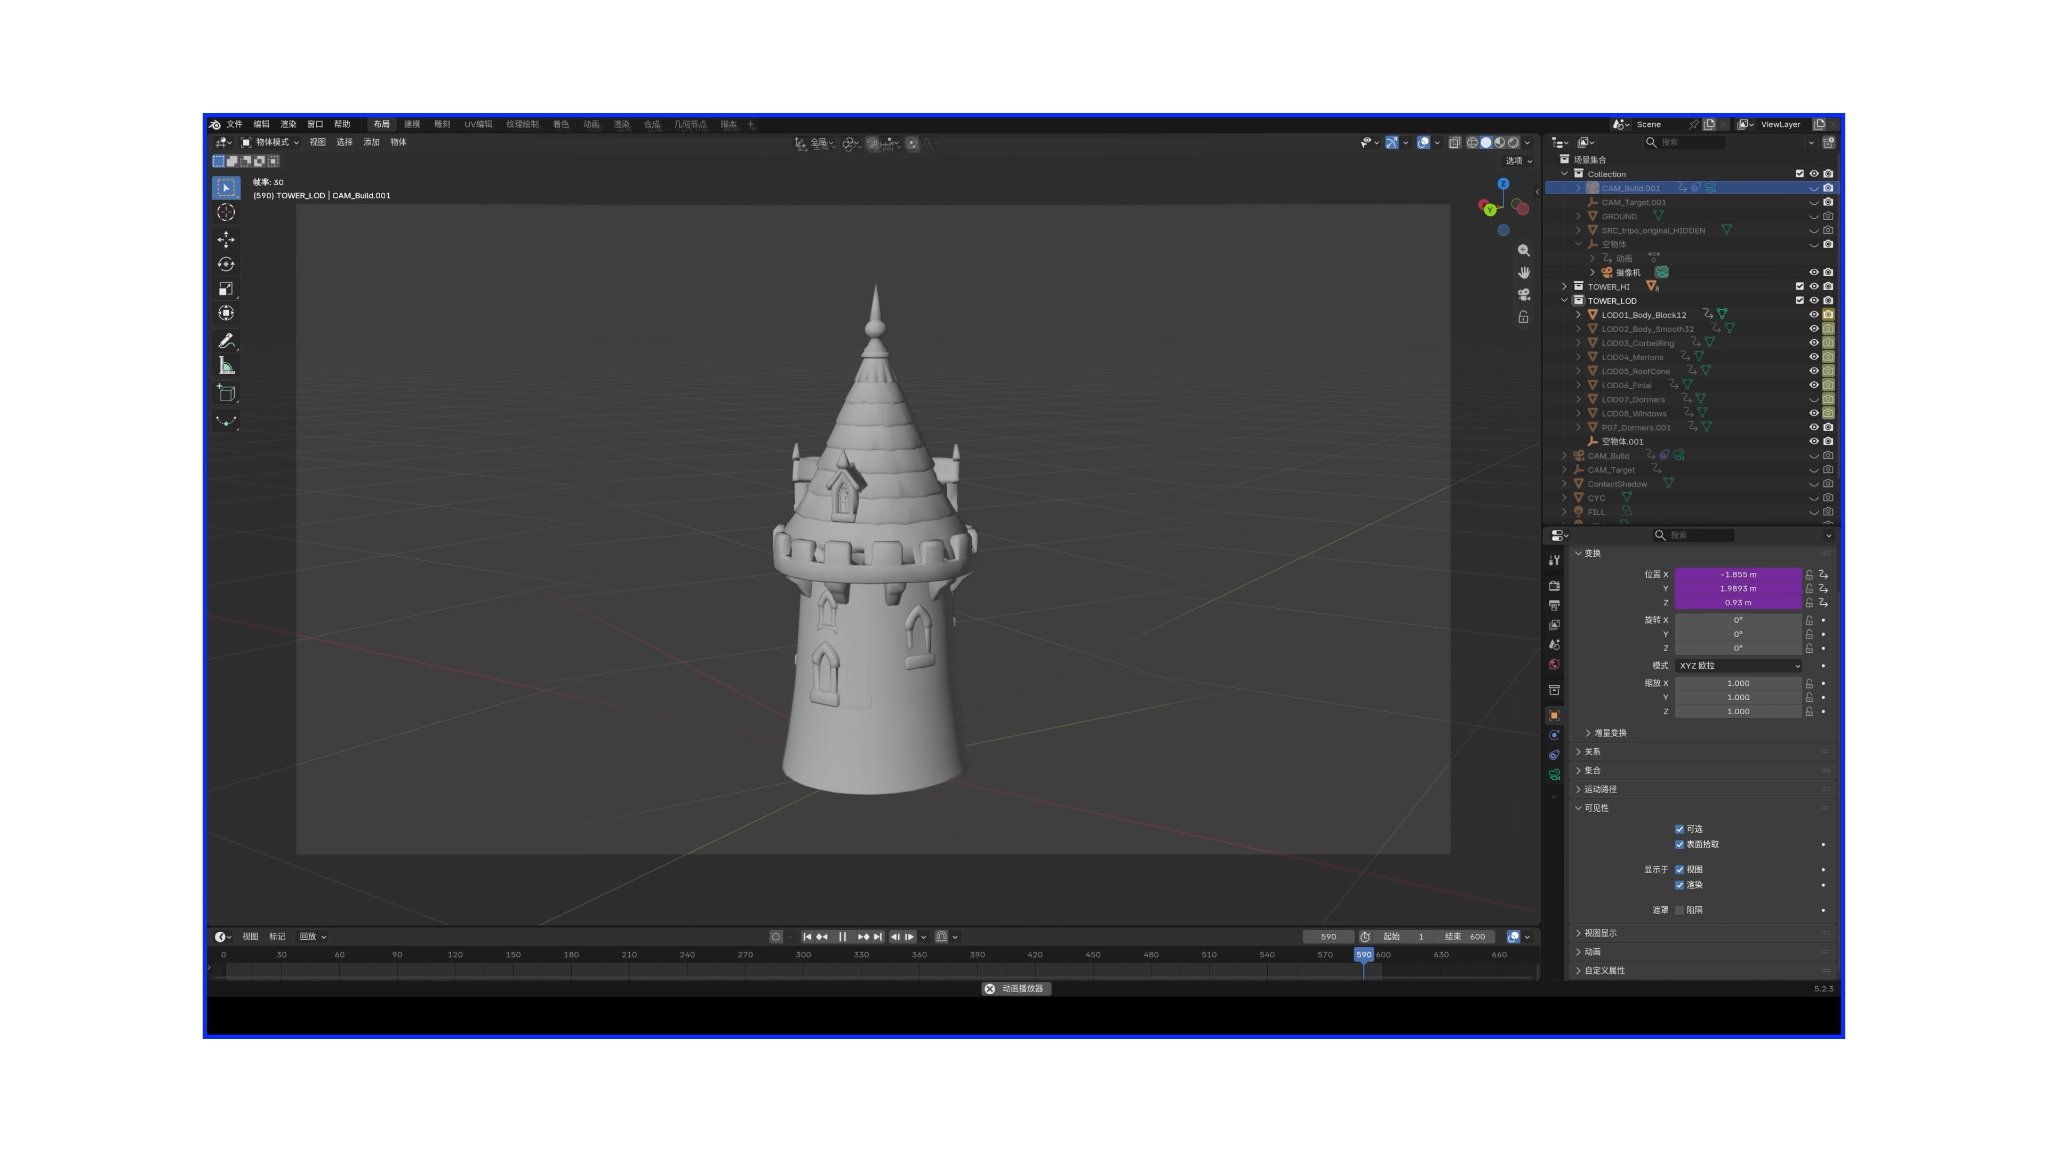
ユーザーはBlenderで3Dシーンを構築し、Unreal Engine、Unity、Godotを使ってプレイ可能なゲームを開発できる。Qwen4-Maxは作成したものを実行し、映像を確認して、結果を洗練させるための調整も行える。
ビジネスリサーチ
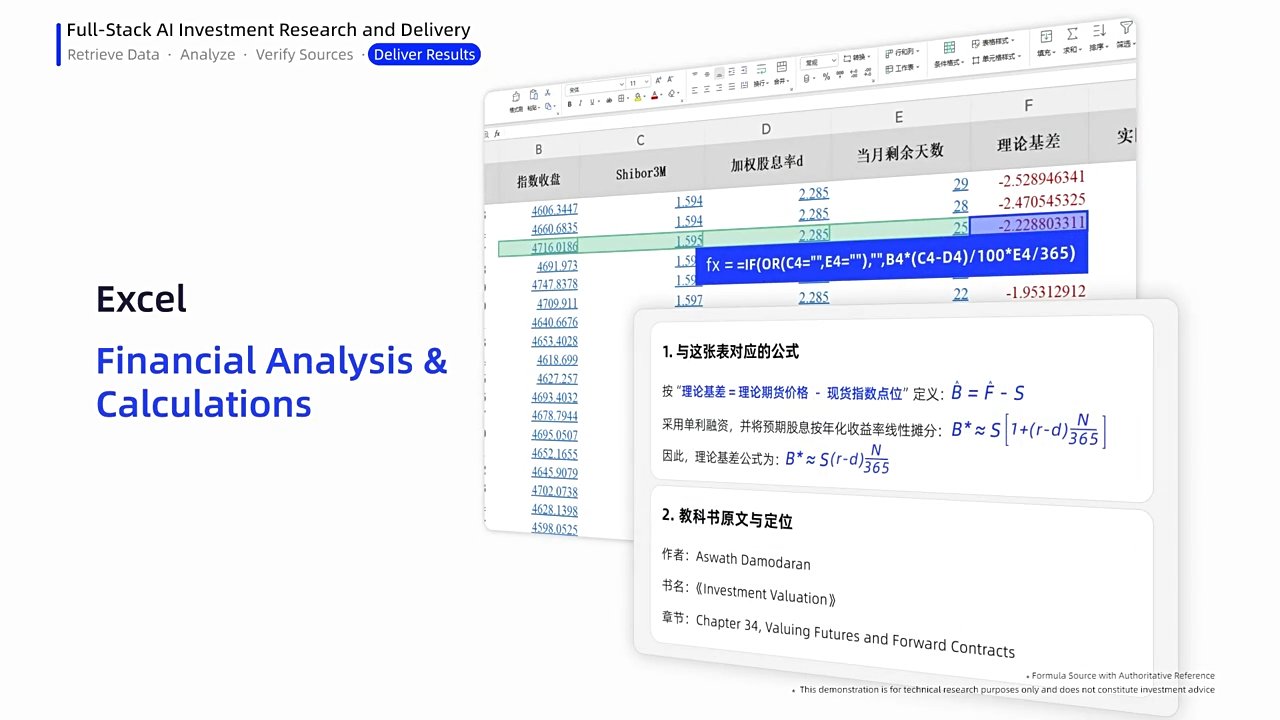
金融分野では、AIが企業情報を分析し、編集可能なスプレッドシートやプレゼンテーションを作成できる。また、文書の確認、裏付けとなる証拠のチェック、参照情報付きでの調査結果の整理を通じて、法務デューデリジェンスも支援できる。
製造
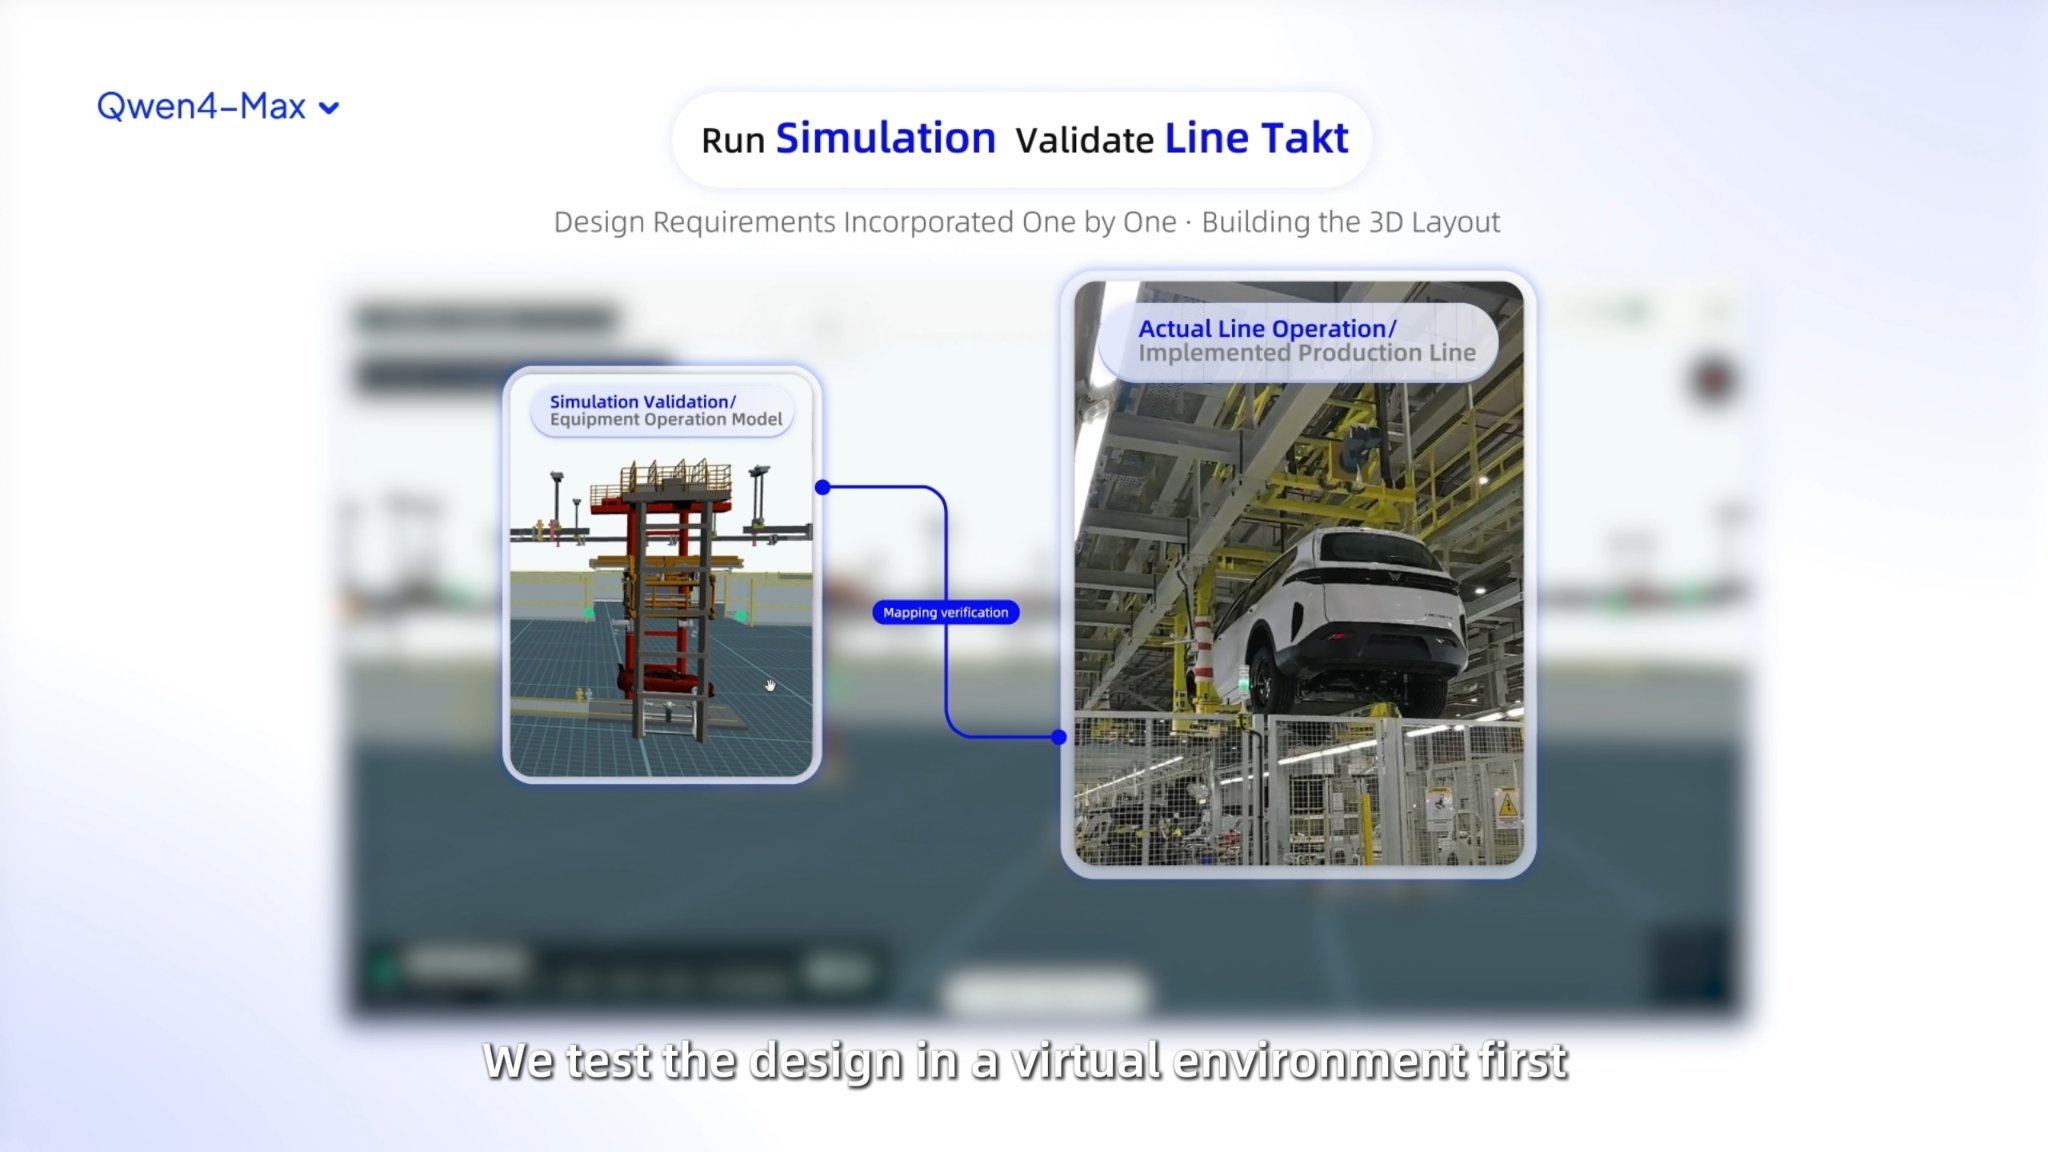
Alibabaは、ある企業の製造デモで、1つのワークピースのプログラミングにかかった時間が、手作業では約475分だったのに対し、24分だったと報告した。シミュレーションのフィードバックを利用して問題を特定し、生産前に加工プロセスを微調整した。
科学研究も、Alibabaが取り組んできた分野の1つだ。同社によると、Qwen4-Maxはアルツハイマー研究の実験で、専門ツールを使って有望な創薬標的を調査し、24種類の候補分子を設計・最適化した。候補分子は計算による評価を受けたが、なお実験室での検証が必要だ。
トークン料金の低下に伴いAPIアクセスを拡大
開発者は現在、QwenCloudを通じて、従量課金のAPI呼び出し、またはサブスクリプション型のToken Planを利用してQwen4-Maxにアクセスできる。QwenStudio、QwenWork、Qoderからも利用可能だ。正式版のリリースは11月11日のプレビューに続くもので、従来のモデル識別子qwen4-max-previewは11月25日に廃止される予定だ。
コスト削減の一部は、モデルアーキテクチャの変更によるものだ。Alibabaは、総パラメーター数を Qwen3.8-Maxと同じ2.4兆個に維持しながら、処理中にアクティブになる割合を25%削減した。つまりAIは、各ステップでより少ない計算能力によって作業を実行できる。
QwenCloudが公開した料金も引き下げられており、システムが以前に処理した情報を再利用する際のコストも含まれる。
100万トークン当たりのAPI料金 | Qwen3.8-Max | Qwen4-Max | 削減率 |
|---|---|---|---|
| 入力 | $2.00 | $1.50 | 25% |
| 出力 | $6.00 | $4.50 | 25% |
| 暗黙的キャッシュ入力 | $0.25 | $0.075 | 70% |
Alibabaによると、節約効果はAPI料金の引き下げをさらに上回る可能性がある。同社独自のWork360ベンチマークでは、平均タスクコストがQwen3.8-Maxより約60%低かったという。ただし、この結果から他のワークロードでも同等の節約が得られるとは限らない。
セキュリティとアクセスも今回のリリースの一部だ。同社は、生成コードの脆弱性を減らすため、トレーニング中に追加のチェックを組み込んだ。対象にはインジェクションの欠陥や、壊れたアクセス制御などが含まれる。Qwen4-Maxは引き続きプロプライエタリなホステッドモデルであり、オープンウェイト版の小型Qwen4バリエーションは今後リリースされる予定だ。
eWeekの検証:Qwen4-Maxの向上は企業タスクによってばらつきがある
Alibaba独自の評価以外で性能を検証するため、eWeekはVals AIが公開したQwen4-Max、Qwen3.8-Max、そしてMoonshot AIの競合モデルであるKimi K3.1 Proの結果を比較した。Valsは、財務分析からソフトウェア開発まで、モデルが業務タスクをどのように処理するかをテストする独立系AIベンチマークプラットフォームだ。
独立ベンチマーク | |||
|---|---|---|---|
| Vals総合インデックス(各種テストの総合性能) | 59.05% | 63.20% | 62.52% |
| Finance Agent v2.1(財務報告書の分析と質問への回答) | 58.83% | 66.68% | 61.49% |
| Legal Research Bench(法律や裁判所の判決の調査) | 46.15% | 41.35% | 37.50% |
| Tax Agent Bench(複雑な法人税の質問への回答) | 49.66% | 40.35% | 24.87% |
| Terminal-Bench 4.0(コンピューターコマンドを使った技術タスクの完了) | 38.89% | 48.48% | 63.64% |
Qwen4-MaxはFinance Agent v2.1とTerminal-Bench 4.0では前モデルを上回ったが、Legal Research BenchとTax Agent Benchでは下回った。Kimi K3.1 Proは、総合スコアがやや低かったにもかかわらず、Terminal-Bench 4.0ではこの3モデルを上回った。
これらの結果が示すのは、テストする価値のあるワークロードであって、部門全体のアップグレードを正当化する根拠ではない。総合ランキングでは専門タスクの違いが見えなくなる可能性があり、ターミナルベースの性能だけでソフトウェア開発全般における優位性を示すことはできない。
コストも、アップグレードの判断を複雑にする。Valsによると、Qwen4-MaxのValsインデックス1回当たりの料金は9.33ドルで、Qwen3.8-Max 0902は8.73ドルだった。これはAlibabaのWork360とは異なる評価だが、トークン料金が安くなっても、完了した作業のコストが必ずしも下がるわけではない理由を示している。
これらは公開されたValsの結果であり、eWeekが実際にテストした結果ではない。また、評価設定はモデルによって異なる。本番環境で採用するモデルを選ぶ前に、企業は候補となる各システムで代表的な作業を実行すべきだ。
確認項目:
- 正確性:結果が元の要件を満たし、結論を裏付けているか。
- 人の作業量:ミスの修正、参照情報の確認、ファイルの修復にかかった時間。
- 完了タスクのコスト:出力結果の確認にかかるコストに加え、再試行や失敗した試行に費やした金額。
業務用ソフトウェアを使うプロジェクトでは、有望な初回応答よりも、利用可能な成果物を得られることのほうが重要だ。実務上のテストでは、必要な総作業量を減らせるほど、モデルが確実に作業を完了できるかどうかが問われる。
AIモデルから、もっと役立つ結果を得たいですか?eWeek読者は、業務でより自信を持ってAIを使えるよう支援する実践的な学習プラットフォーム、The Neuron Academyを7日間無料で利用できます。すべてのレッスンを見る →
無料でAIへの話しかけ方を学びましょう!The Neuron Academyの6分間コースを試して、より良いプロンプトを書き、AIから役立つ結果を得るための簡単な方法を学んでください。そのほかのAIコースも7日間無料で閲覧できます。すべてのレッスンをこちらで確認 →